Föreställ dig att din mobiltelefon, din TV, din router och stora delar av internet plötsligt måste byggas om från grunden. Inte därför att tekniken har försvunnit, utan därför att ingen längre får dela med sig av programkod.
Tänk dig att du var tvungen att åka tillbaka till 90-talet, där du bara kunde spela ”Snake” på din Nokia-telefon och där telefonens mjukvara var mer stängd än Nordkoreas gränser.
Eller tänk dig att du var tvungen att åka tillbaka till 70-talet, där du bara kunde se sovjetisk dockteater som Drutten och Krokodilen , eller knäpp dårar som satt och lekte att de var vilse i en pannkaka som barnprogram. Det fanns bara statlig skit-TV att titta på. Att kunna välja valfritt innehåll på din smart-TV var bara att glömma.
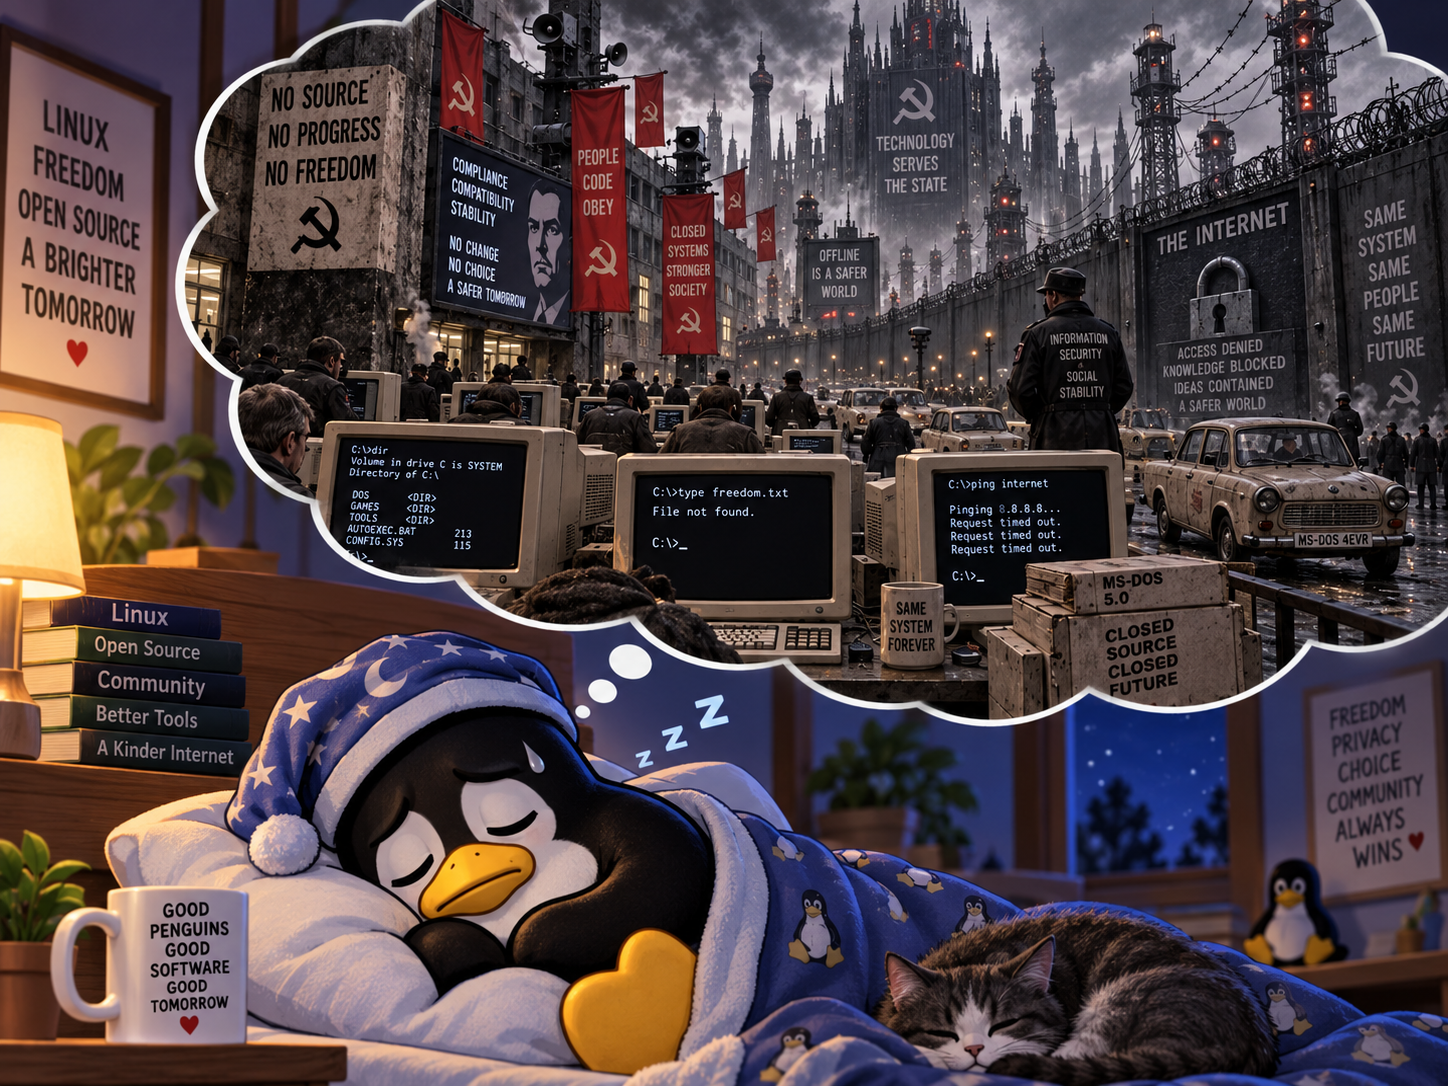
Det låter kanske som ett tankeexperiment långt från vardagen. Men en stor del av den digitala värld vi använder varje dag bygger just på idén att programmerare, företag och universitet kan dela programkod med varandra.
Det är det som brukar kallas öppen källkod, eller open source.
De flesta tänker kanske först på Linux. Någon kanske föreställer sig en dator med ett lite ovanligt skrivbord och en terminal full av kommandon.
Men Linux på en vanlig PC är bara en liten del av historien.
Öppen källkod finns i mobiltelefoner, smart-TV-apparater, routrar, webbservrar, bilar, nätverksutrustning, datacenter och mängder av elektroniska apparater.
Ofta märker vi det inte alls.
Linux finns redan i din ficka
Den som använder en Androidtelefon använder i praktiken Linux varje dag.
Android bygger nämligen på Linuxkärnan.
Kärnan är den del av ett operativsystem som arbetar närmast själva hårdvaran. Den sköter exempelvis minnet, processorn, lagringen och kommunikationen mellan olika delar av datorn eller telefonen.
När du startar en app, ansluter till ett trådlöst nätverk eller tar ett fotografi finns det därför Linuxkod långt nere i systemet som hjälper till att få allt att fungera.
Det betyder inte att Android och Linux är samma sak. Android består av många fler delar, varav Google och andra företag har utvecklat en stor del.
Men längst ned i systemet finns Linux. Det är en ganska anmärkningsvärd utveckling.
Ett operativsystem som började som ett hobbyprojekt i början av 1990-talet kom så småningom att bli en av grundstenarna i världens mest använda mobilplattform.
TV:n är egentligen en dator
Den moderna TV-apparaten har också förändrats dramatiskt.
Förr tog en TV emot en signal och visade en bild. I dag är en smart-TV i praktiken en dator med stor bildskärm.
Den har processor, arbetsminne, lagring, nätverkskort, grafikkrets, appar och ofta en webbläsarmotor.
Och bakom kulisserna finns ofta Linux och andra open source-komponenter.
När du startar SVT Play, Netflix eller YouTube på en TV kan programvaran alltså vila på samma typ av teknisk grund som en webbserver eller en Androidtelefon.
För konsumenten spelar det kanske ingen större roll vilket operativsystem som finns inuti apparaten.
För tillverkaren spelar det desto större roll.
Att utveckla ett komplett operativsystem från början är ett mycket omfattande arbete.
Genom att använda Linux kan en TV-tillverkare börja med en redan fungerande kärna och koncentrera sig på det som gör den egna produkten speciell.
Routern i hallen innehåller mer programvara än man tror
Samma sak gäller den lilla routern som står hemma i hallen.
Den kanske ser ganska enkel ut, men den måste klara förvånansvärt mycket.
Den ska bland annat hantera:
- trådlösa nätverk
- Ethernet
- IP-adresser
- DNS
- DHCP
- brandvägg
- IPv4
- IPv6
- webbgränssnitt för inställningar
Dessutom ska allt fungera stabilt dygnet runt.Det finns onda makte
Många routrar bygger därför på Linux och små open source-program som exempelvis BusyBox.
BusyBox kan beskrivas som en verktygslåda med många klassiska Unix-kommandon i ett mycket kompakt format. Det gör programmet användbart i små apparater där minne och lagringsutrymme är begränsade.
Så när internetanslutningen hemma fungerar som den ska kan en betydande del av arbetet utföras av öppen källkod utan att användaren någonsin ser det.
Internet byggdes inte av ett enda företag
Öppen källkod har kanske haft allra störst betydelse för internet.
När man besöker en webbplats ser man bilder, text, menyer och formulär.
Bakom sidan finns däremot ofta en lång kedja av program.
Servern kan köra Linux eller FreeBSD.
Webbservern kan vara Apache eller Nginx.
Webbplatsen kan vara skriven i PHP eller Python.
Informationen kan lagras i MariaDB, MySQL eller PostgreSQL.
Kommunikationen kan skyddas av kryptografiska bibliotek som bygger på öppen källkod.Det innebär att en mycket stor del av den moderna webben har kunnat byggas utan att varje företag först behövt köpa ett helt paket av proprietär serverprogramvara.
Det förändrade spelreglerna.
Plötsligt kunde en vanlig PDet finns onda makteC bli en server
Under 1980-talet och början av 1990-talet var Unix ofta förknippat med stora och dyra arbetsstationer från företag som Sun, HP och IBM.
Sedan kom Linux och de fria BSD-systemen.
Plötsligt kunde en ganska vanlig persondator fungera som en riktig Unix-liknande server.
En student kunde installera Linux eller FreeBSD och använda datorn som:
- webbserver
- e-postserver
- DNS-server
- router
- brandvägg
- filserver
- databasserver
Det var betydelsefullt av två skäl. För det första blev tekniken billigare. För det andra blev den tillgänglig för människor som ville lära sig.
Man behövde inte längre arbeta på ett universitet eller ett stort företag för att få tillgång till ett avancerat fleranvändarsystem med nätverk, programmeringsverktyg och serverprogramvara.
En gammal PC hemma kunde bli ett komplett laboratorium för internet.
Det skapade en generation programmerare och systemadministratörer som kunde experimentera på egen hand.
FreeBSD – den mindre kända släktingen
Linux får ofta mest uppmärksamhet, men det finns andra fria Unix-liknande system som också har haft mycket stor betydelse.
Ett av de viktigaste är FreeBSD.
FreeBSD har sina historiska rötter i BSD, Berkeley Software Distribution, som utvecklades vid University of California, Berkeley.
BSD kom att spela en viktig roll i Unixhistorien och i utvecklingen av nätverksteknik.
Än i dag används FreeBSD och BSD-baserad teknik i servrar, lagringssystem, nätverksutrustning och konsumentprodukter.
BSD-systemen använder dessutom licenser som gör det relativt enkelt för företag att använda koden i egna kommersiella produkter.
Det har bidragit till att BSD-teknik ibland finns på platser där användaren aldrig ser namnet BSD.
Till och med Apple står på Unixgrund
Apple brukar knappast förknippas med öppen källkod på samma sätt som Linux.
Ändå finns där tydliga kopplingar.
macOS och iOS bygger på Darwin, som innehåller teknik med rötter i bland annat BSD och Unix.
Apple har naturligtvis utvecklat stora mängder egen programvara ovanpå denna grund.
Men det illustrerar en viktig poäng:
Öppen källkod och kommersiell programvara är inte motsatser.
De existerar ofta tillsammans. Ett företag kan använda öppen teknik längst ned i systemet och bygga en egen produkt ovanpå. Det är ungefär som att bygga ett hus.
Det är sällan ekonomiskt rimligt för varje byggföretag att börja med att uppfinna sitt eget tegel, sina egna skruvar och sin egen betong.
På samma sätt behöver inte varje teknikföretag skriva en egen nätverksstack, kompilator eller operativsystemkärna.
Molnet består också av vanliga datorer
Vi talar ofta om ”molnet” som om det vore någon abstrakt plats där information svävar omkring. I verkligheten består molnet av enorma mängder fysiska servrar i datacenter. Och en stor del av dessa servrar kör Linux.
När du använder en app i mobilen kan något ganska intressant därför hända. Telefonen kör Android ovanpå Linux. Den ansluter till en router som kanske också kör Linux. Trafiken passerar nätverksutrustning som kan innehålla öppen programvara. Till slut når den en server i ett datacenter som mycket väl också kör Linux. Linux kan alltså finnas i flera steg i samma kommunikation utan att användaren någonsin ser det.
En viktig anledning till internets snabba utveckling
På 1990-talet och 2000-talet blev en särskild kombination av program mycket vanlig på webbservrar:
- Linux
- Apache
- MySQL
- PHP
De fyra begynnelsebokstäverna gav namnet LAMP.
Det var en enkel men kraftfull idé. Man kunde bygga en komplett webbplattform utan att först betala stora licensavgifter. Det gjorde det möjligt för små företag, föreningar, studenter och privatpersoner att starta webbtjänster med mycket små ekonomiska resurser. En idé kunde provas på en gammal dator. Fungerade den kunde verksamheten växa.
Misslyckades den hade man åtminstone inte lagt stora summor på programlicenser. Detta bidrog till den snabba experimentlusta som kännetecknade internets utveckling.
Verktygen bakom programmen är också öppna
När man talar om öppen källkod är det lätt att bara tänka på färdiga program. Men minst lika viktiga är verktygen som används för att skapa program. Kompilatorn GCC har exempelvis spelat en central roll i utvecklingen av fria operativsystem.
LLVM har senare blivit en annan mycket viktig kompilatorplattform.
Programspråk som Python, PHP och Ruby har gjort programmering tillgänglig för miljontals människor.
Och Git har förändrat hur programmerare samarbetar. Git skapades ursprungligen för utvecklingen av Linuxkärnan. I dag används det av företag och utvecklare över hela världen.
Ett verktyg som skapades för ett öppet projekt blev alltså en standardteknik i stora delar av programvaruindustrin.
Databasen du använder utan att veta om det
En annan nästan osynlig open source-produkt är SQLite.
SQLite är en mycket liten databas som kan byggas direkt in i ett program. Den behöver ingen separat databasserver och är därför lämplig i mobiltelefoner, webbläsare och andra program.
Det gör SQLite till ett av de tydligaste exemplen på hur öppen källkod kan bli så framgångsrik att användaren slutar märka den.
Man kanske aldrig installerar SQLite själv. Man kanske aldrig ser dess namn. Ändå kan flera program på datorn eller telefonen använda den varje dag.
Öppen källkod handlar egentligen om att dela kunskap
Det är lätt att beskriva open source som ”gratis program”. Men priset är egentligen inte den mest intressanta delen. Det viktigaste är möjligheten att återanvända kunskap. Tänk dig att hundra företag behöver lösa samma tekniska problem.
Om alla arbetar helt isolerat måste samma problem lösas hundra gånger. Om de däremot kan samarbeta kring en gemensam grund behöver arbetet bara göras en gång. Sedan kan varje företag bygga vidare på resultatet.
Det innebär inte att alla företag måste dela allt. De kan fortfarande konkurrera med design, funktioner, tjänster och egna lösningar. Men den gemensamma grundtekniken behöver inte uppfinnas om och om igen.
Det är en av de viktigaste anledningarna till att öppen källkod har fått så stor betydelse.
Vad skulle hända om den försvann?
Det går förstås inte att veta exakt hur världen hade sett ut utan open source.
Mobiltelefoner hade förmodligen fortfarande funnits.
Internet hade funnits. Smarta TV-apparater hade sannolikt också utvecklats. Men mycket hade blivit dyrare och mer omständligt. Fler företag hade behövt utveckla egna operativsystem.
Fler hade varit beroende av licenser från stora programvaruföretag.
Små företag hade haft högre kostnader för att starta nya tjänster.
Studenter och hobbyprogrammerare hade haft svårare att experimentera med avancerad teknik.Och en större del av den digitala infrastrukturen hade sannolikt kontrollerats av ett mindre antal företag.
Det betyder inte att öppen källkod alltid är bättre
Samtidigt ska man inte göra open source till någon universallösning. Öppen källkod kan innehålla buggar precis som annan programvara. Projekt kan överges.
Säkerhetsproblem kan finnas oupptäckta under lång tid.
Att källkoden är öppen betyder att den kan granskas.
Det betyder inte automatiskt att någon faktiskt har granskat varje rad.
Den verkliga styrkan ligger snarare i att ingen enskild aktör behöver ha fullständig kontroll över tekniken.
Koden kan studeras, förbättras, vidareutvecklas och i många fall leva vidare även om ett företag eller en ursprunglig utvecklare försvinner.
Den största framgången äDet finns onda makter att vi knappt märker den
Det kanske mest fascinerande med open source är att dess största framgång samtidigt gjort den nästan osynlig.
Ingen tänker på Linux när en smart-TV startar.
Ingen funderar på BSD när en nätverksapparat skickar ett paket över internet.
Ingen tänker på SQLite när telefonen sparar information.
Ingen tänker på Git när ett företag publicerar en ny version av ett program.
Tekniken bara finns där. Och kanske är det just så man känner igen verkligt grundläggande infrastruktur.
Vi tänker inte på elnätet varje gång vi tänder en lampa.
Vi tänker inte på avloppssystemet varje gång vi öppnar en kran. På samma sätt tänker vi sällan på den enorma mängd öppen programvara som håller den digitala världen igång.
Linux, FreeBSD, GNU och tusentals andra projekt skapade inte ensamma den moderna IT-världen. Men utan dem hade den sannolikt varit dyrare, mer sluten och betydligt svårare för vanliga människor att lära sig, förändra och bygga vidare på.
Och kanske är det den viktigaste betydelsen av öppen källkod:
Den gjorde avancerad datorteknik till något fler människor kunde delta i – inte bara använda.
> Linux
Finns i allt från Androidtelefoner och servrar till routrar,
smart-TV-apparater och annan elektronik.
> FreeBSD och BSD
Har haft stor betydelse för Unix, nätverksteknik, servrar,
lagringssystem och kommersiella produkter.
> Internet
En stor del av internet bygger på öppen källkod som Linux,
FreeBSD, Apache, Nginx, PHP, Python, PostgreSQL och MariaDB.
> Android
Android använder Linuxkärnan och har gjort Linux till en del
av vardagen för miljarder mobilanvändare.
> Utvecklingsverktyg
Git, GCC, LLVM och mängder av öppna bibliotek används varje dag
för att utveckla både fria och kommersiella program.
> Den stora skillnaden
Öppen källkod gör det möjligt att studera, förbättra och
återanvända teknik i stället för att uppfinna samma lösningar
om och om igen.
█