• AI-robotar pressar Kernel.org – miljontals automatiska anrop varje dag

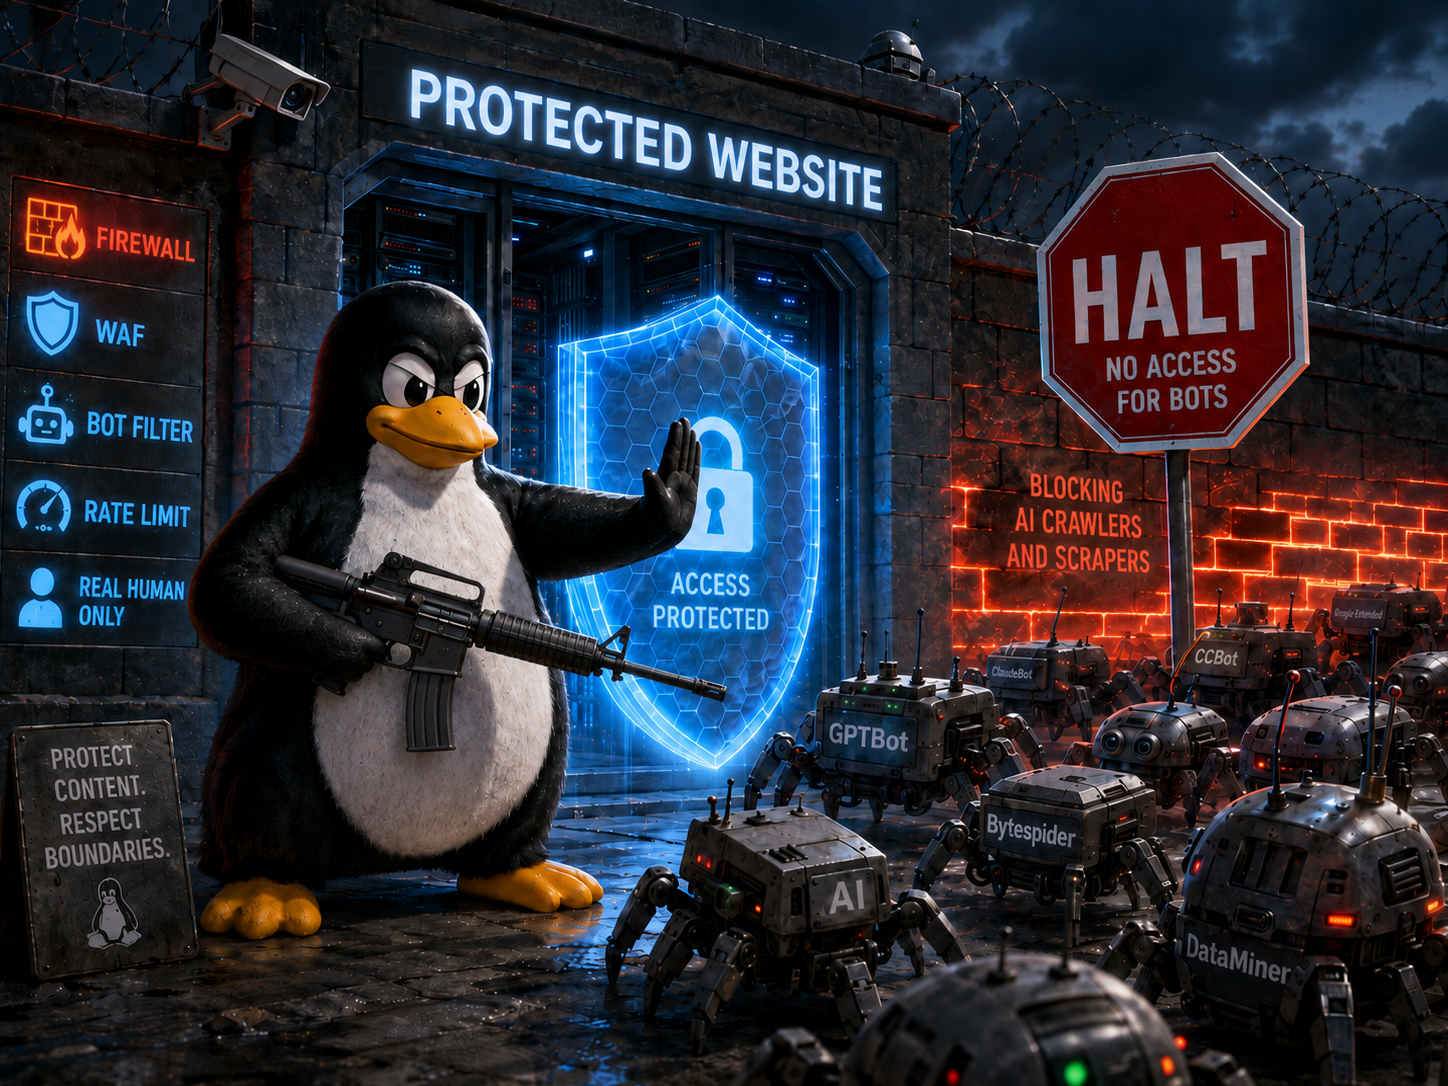
    Kernel.org, en av de viktigaste infrastrukturerna bakom utvecklingen av Linux, utsätts för miljontals automatiska förfrågningar varje dygn. En stor del tros komma från AI-relaterade insamlingsrobotar. Nu går omkring en femtedel av serverkapaciteten åt till att hantera trafiken.
    Linux utvecklas helt öppet. Källkod, ändringar, diskussioner och historik finns tillgängliga för vem som helst att läsa och ladda ner. Det är en av grundidéerna bakom öppen källkod.

    Men öppenheten har också fått en oväntad baksida.

    Kernel.org, som bland annat driver git.kernel.org och tillhandahåller en stor del av Linuxkärnans utvecklingshistorik, får i dag omkring sex miljoner förfrågningar per dygn som försöker öppna enskilda ändringar, så kallade commits.

    En mycket stor del av trafiken verkar komma från automatiserade insamlingsprogram.

    Konstantin Ryabitsev, som arbetar med Kernel.orgs infrastruktur, beskriver situationen som en ständig bakgrundsbelastning på servrarna.

    Enligt honom används omkring 14–16 processorkärnor kontinuerligt enbart till att omvandla Git-data till webbsidor åt automatiserade besökare.

    Totalt förfogar infrastrukturen över omkring 90 processorkärnor fördelade på fem geografiska platser.

    Det innebär att ungefär 20 procent av den samlade beräkningskapaciteten periodvis används för att hantera denna typ av trafik.

    Informationen finns redan att ladda ner

    Det märkliga är att nästan all information som robotarna försöker samla in redan går att hämta betydligt effektivare.

    Git är konstruerat för att hela kodarkiv ska kunna kopieras.

    Den som vill analysera Linuxkärnans utvecklingshistorik kan därför klona ett Git-arkiv och sedan arbeta med materialet lokalt.

    Även Linux Kernel Mailing List, LKML, och andra utvecklingsarkiv går att ladda ner.

    Trots det försöker många automatiserade system i stället öppna webbsidan för varje enskild kodändring.

    Det är ungefär som att vilja läsa ett uppslagsverk men, i stället för att hämta hela boken, ringa biblioteket och be personalen kopiera en enda sida åt gången – miljontals gånger.

    Problemet är att varje sådan webbsida måste skapas av servern.

    Git-datan ska hämtas, tolkas och omvandlas till HTML innan den skickas till besökaren.

    1,48 miljoner ändringar – och hundratals kopior

    Linuxkärnans huvudsakliga Git-arkiv innehåller omkring 1,48 miljoner commits.

    Men git.kernel.org innehåller dessutom hundratals så kallade forks, alltså utvecklingsgrenar och kopior som bygger på samma kodhistorik.

    Ryabitsev uppger att det finns omkring 922 sådana varianter.

    För Kernel.org är detta normalt inget större lagringsproblem eftersom samma Git-objekt kan återanvändas.

    För en webbrobot ser situationen annorlunda ut.

    Samma ändring kan förekomma under ett stort antal olika webbadresser i olika arkiv.

    Dessutom kan webbgränssnittet visa informationen på flera olika sätt: som vanlig webbsida, patch, diff, rå text och olika jämförelser mellan versioner.

    Resultatet blir ett närmast astronomiskt antal möjliga webbadresser.

    En dåligt konstruerad insamlingsrobot kan därför fortsätta följa länkar och begära nya sidor under mycket lång tid, trots att stora delar av informationen är identisk.

    Från tydliga robotar till förklädda webbläsare

    Till en början gick problemet relativt enkelt att hantera.

    Automatiserade robotar identifierade sig ofta genom sin så kallade user-agent, den text en webbläsare skickar till servern för att tala om vilket program den använder.

    Kernel.org kunde därför blockera de mest aggressiva robotarna.

    När robotarna började låtsas vara vanliga webbläsare gick administratörerna i stället över till att blockera IP-adresser.

    Även det fungerade ett tag.

    Servrar som skickade onormalt stora mängder förfrågningar kunde identifieras och spärras.

    Men även den metoden började så småningom förlora sin effekt.

    Trafiken började komma från vanliga hem

    Ett betydligt svårare problem uppstod när förfrågningarna började komma från mängder av vanliga bostads- och mobilnät.

    En enskild IP-adress kunde skicka några få anrop och sedan aldrig återkomma.

    Det gjorde traditionell IP-blockering nästan meningslös.

    Bakgrunden är marknaden för så kallade residential proxies.

    Genom sådana nätverk kan trafik skickas via vanliga internetanslutningar i hem, mobiltelefoner eller andra uppkopplade enheter.

    För en server kan trafiken därför se ut som om den kommer från helt vanliga användare.

    I vissa fall byggs proxyfunktioner in i appar och annan konsumentprogramvara. En användares internetanslutning kan då bli en del av ett kommersiellt proxynätverk.

    För Kernel.org innebär det att en automatiserad insamlingsrobot inte längre behöver komma från ett lättidentifierat datacenter.

    Den kan i stället dyka upp från tusentals eller miljontals olika konsumentanslutningar.

    Anubis skulle göra robotarna dyrare

    För att bromsa utvecklingen införde Kernel.org systemet Anubis.

    Principen bygger på så kallad proof-of-work.

    Innan en besökare får komma åt webbplatsen måste datorn utföra en mindre matematisk beräkning.

    För en människa som besöker enstaka sidor är kostnaden relativt liten.

    För en robot som vill hämta miljontals sidor kan samma beräkning däremot bli mycket kostsam.

    Till en början fungerade lösningen bra.

    Robotarna försvann i stor utsträckning.

    Men efter några månader började automatiserade system även lösa dessa beräkningsuppgifter.

    Kernel.org höjde då svårighetsgraden.

    Problemet var att även vanliga användare drabbades.

    På exempelvis en mobiltelefon kunde beräkningen ta flera sekunder och samtidigt belasta processorn så mycket att telefonen blev märkbart varm.

    Så småningom började även robotarna klara den högre svårighetsgraden.

    Två tredjedelar stoppas – resten fortsätter

    I dag stoppas omkring 66 procent av förfrågningarna redan vid Anubis-kontrollen.

    Men ungefär en tredjedel av trafiken klarar beräkningen och går vidare till själva git.kernel.org.

    Det innebär fortfarande miljontals förfrågningar.

    Det är svårt att med säkerhet skilja en automatiserad besökare från en människa när båda använder vanliga IP-adresser och beter sig som moderna webbläsare.

    Men enligt Kernel.orgs uppskattningar kan legitim mänsklig trafik utgöra så lite som omkring två procent av den totala belastningen på tjänsten.

    Ett typiskt exempel är gamla commits i övergivna utvecklingsgrenar. Det är osannolikt att tusentals människor samtidigt sitter och klickar sig igenom sådant material manuellt.

    Linuxkoden är attraktiv för AI

    En anledning till det stora intresset är att Linuxkärnans utvecklingshistorik är ett ovanligt värdefullt dataset.

    Här finns miljontals exempel på riktig programkod tillsammans med förändringar, kommentarer, diskussioner och utvecklingshistorik som sträcker sig långt tillbaka i tiden.

    Dessutom är en stor del av materialet skapat innan dagens generativa AI-system slog igenom.

    För företag som bygger eller tränar modeller för programmering är sådant material potentiellt mycket attraktivt.

    Det går däremot inte att avgöra exakt vilken organisation eller vilket ändamål som ligger bakom varje automatiserad förfrågan.

    Begreppet ”AI-crawler” används därför ofta som en samlingsbeteckning för den nya våg av aggressiva datainsamlare som blivit vanlig i takt med AI-boomen.

    Öppen information kan bli svårare att läsa på webben

    Kernel.org planerar nu ytterligare begränsningar.

    En möjlighet är att minska antalet webbadresser som automatiserade system kan följa.

    Vissa funktioner som kräver mycket serverkapacitet kan också komma att begränsas för anonyma besökare.

    Det betyder inte att Linux utvecklingsdata ska göras privat.

    Tvärtom betonar Kernel.org att källkod och historik även fortsättningsvis ska gå att ladda ner.

    Skillnaden är att den som vill samla in mycket stora datamängder kan behöva använda effektivare metoder, exempelvis Git, i stället för att begära miljontals individuellt genererade webbsidor.

    Ett växande problem för det öppna internet

    Kernel.org är långt ifrån ensamt.

    Webbplatser, arkiv, dokumentationsprojekt och olika open source-tjänster har under de senaste åren rapporterat kraftigt ökande belastning från automatiserade insamlingsrobotar.

    Problemet skapar en svår balansgång.

    Internet och öppen källkod bygger i stor utsträckning på att information ska vara tillgänglig.

    Samtidigt kostar varje serverförfrågan resurser i form av processorkraft, bandbredd och elektricitet.

    När en människa öppnar några sidor är kostnaden försumbar.

    När ett automatiserat system gör samma sak miljontals gånger förändras situationen helt.

    För Kernel.org har den skillnaden nu blivit mycket konkret: en betydande del av infrastrukturen arbetar dygnet runt med att skapa webbsidor åt automatiserade system – trots att samma information redan går att ladda ner betydligt effektivare.

    Det är ett exempel på en ny konflikt på nätet.

    Frågan är inte längre bara vem som får läsa offentlig information.

    Den handlar också om hur mycket resurser en maskin ska få använda för att läsa den.

    https://people.kernel.org/monsieuricon/creepy-crawlies

    > FAKTA: AI-TRAFIKEN MOT KERNEL.ORG

    Dagliga förfrågningar: cirka 6 miljoner

    Stoppas av Anubis: cirka 66 %

    Förfrågningar som tar sig igenom: cirka 33 %

    Beräknad legitim trafik: omkring 2 %

    Serverkapacitet: 90 CPU-kärnor på fem geografiskt distribuerade noder

    Kapacitet som används för scrapers: cirka 14–16 CPU-kärnor kontinuerligt

    Andel av total CPU-kapacitet: omkring 20 %

    Linux huvudarkiv: cirka 1,48 miljoner commits

    Forks på git.kernel.org: omkring 922
    root@kernel.org:~$ Problemet är inte att informationen är hemlig – den går redan att hämta via Git. Belastningen uppstår när automatiserade system begär miljontals individuellt renderade webbsidor.
  • AI hjälpte Linus Torvalds hitta Linuxbugg efter 18 omstarter

    Ett avrundningsfel på en enda kodrad gjorde delar av ett reserverat grafikminne tillgängligt för vanliga program. Resultatet blev skadade data och svart skärm. För att hitta orsaken tog Linus Torvalds hjälp av AI – men det krävdes 24 felsökningspatchar och 18 omstarter innan gåtan var löst.

    AI används i allt fler delar av programutvecklingen, och nu har tekniken även spelat en viktig roll vid felsökning av själva Linuxkärnan.

    Linux skapare Linus Torvalds berättar i en kodändring i Linuxkärnan hur AI hjälpte honom att hitta ett ovanligt svårupptäckt fel i grafikdrivrutinen Intel Xe. Han beskriver arbetet som en ”debug session from hell” – en felsökningssession från helvetet.

    Problemet drabbade Torvalds egen dator med en Intel Battlemage G21-grafikkrets och 16 GiB grafikminne. När datorn startades visades ingen vanlig inloggningsskärm. I stället möttes han av en svart skärm medan inloggningshanteraren GDM gång på gång försökte starta om skrivbordets grafikprocess.

    Datorn fungerade i övrigt, men grafiksystemet kom aldrig längre än till sitt första riktiga arbete.

    En gräns drogs åt fel håll

    Felet fanns i hanteringen av en del av grafikminnet som används för kompressionsdata, så kallad Flat CCS. CCS kan förenklat beskrivas som metadata som hjälper grafikkretsen att hålla reda på hur olika delar av grafikminnet är komprimerade.

    Detta område måste vara reserverat för grafikkretsens egen hårdvara. Operativsystemets vanliga minneshanterare får därför inte dela ut det till program eller använda det för exempelvis sidtabeller.

    Intel Xe-drivrutinen läste adressen där det reserverade CCS-området började. Adressen avrundades sedan uppåt till närmaste gräns på 128 KiB. Allt grafikminne under den avrundade adressen betraktades därefter som ledigt och användbart.

    Det låter kanske rimligt, men gränsen markerade var det användbara minnet slutade – inte var ett nytt ledigt område började. Genom att avrunda uppåt råkade drivrutinen därför lägga en liten del av det reserverade CCS-minnet i den fria minnespoolen.

    Man kan jämföra det med en lagerhylla där halva den sista hyllplatsen redan är reserverad. Om lagrets tillgängliga utrymme avrundas uppåt räknas hela hyllplatsen som ledig, trots att den reserverade delen fortfarande används.

    Två kilobyte räckte för att slå ut skrivbordet

    På Torvalds dator handlade överlappningen om endast två kibibyte. Eftersom minneshanteraren arbetar med hela minnessidor hamnade det reserverade området ändå på samma sida som minne vilket drivrutinen kunde dela ut.

    Vid varje kallstart råkade Mesa, den öppna grafikstacken som används av Linux, placera en viktig sidtabell på just denna minnessida. Sidtabeller fungerar ungefär som kartor som visar grafikkretsen var olika data finns i minnet.

    Samtidigt skrev grafikkretsens kompressionshårdvara sina metadata i den reserverade delen av sidan. Den behövde varken något vanligt program, någon bufferthantering eller en särskild GPU-instruktion för att göra det. Skrivningen skedde direkt i hårdvaran – till och med innan användarmiljön hade startat.

    När kompressionsinformationen skrevs förstördes delar av Mesas sidtabell. Därmed försvann den post som pekade på minnet där kompositörens kommandon låg. När skrivbordsmiljön skickade sitt första arbete till grafikkretsen kunde GPU:n inte längre hitta instruktionerna.

    Resultatet blev ett grafikfel, varefter GDM startade om kompositören. Samma sak upprepades och användaren blev kvar framför en svart skärm.

    En manuell omstart av GDM kunde däremot få systemet att fungera, eftersom den nya grafikprocessen fick sina sidtabeller placerade på en annan plats i minnet. Det gjorde felet ännu svårare att förstå: hårdvaran verkade fungera, och problemet kunde tillfälligt försvinna utan att någon kod hade ändrats.

    AI gjorde det tidskrävande arbetet

    För att hitta orsaken behövde Torvalds lägga till allt mer detaljerad diagnostik i drivrutinen. Sammanlagt krävdes 24 tillfälliga felsökningspatchar och 18 starter med olika versioner av Linuxkärnan.

    AI fick göra mycket av det repetitiva arbetet: lägga till ny felsökningskod, bearbeta den insamlade informationen och föreslå nästa kontroll. Torvalds styrde undersökningen och bestämde vilka spår som skulle följas.

    Enligt honom ville AI-systemet ge upp vid flera tillfällen. Det hävdade att problemet inte gick att lösa och föreslog att de i stället skulle sammanställa en rapport om vad som hade undersökts. Torvalds fortsatte dock att pressa fram nya tester.

    När AI:n fick tydliga instruktioner att fortsätta tog den fram ytterligare diagnostik och analyserade resultaten. Till slut kunde minnesskadan knytas till CCS-området och den felaktigt avrundade adressen.

    Torvalds lät även AI skriva den långa tekniska beskrivningen i den färdiga kodändringen.

    En rättning på en kodrad

    Själva lösningen var nästan komiskt liten. I stället för att avrunda gränsen uppåt ändrades koden så att den avrundades nedåt till den sidstorlek som minneshanteraren använder.

    På den berörda datorn innebar det att exakt en minnessida undantogs från den tillgängliga minnespoolen. När Torvalds därefter läste innehållet i den reserverade sidan kunde han se ett regelbundet mönster av kompressionsmetadata – ett tydligt bevis på vad som hade skrivit över sidtabellen.

    Drivrutinen innehöll redan en kontroll som var tänkt att upptäcka problemet. Den var dock utformad på ett sådant sätt att den felaktigt avrundade adressen kunde godkännas just i det fall som kontrollen skulle fånga. Dessutom var kontrollen endast aktiv när ett särskilt felsökningsalternativ för Intel Xe-drivrutinen hade aktiverats.

    Även den kontrollen har nu ersatts med en som faktiskt kan upptäcka om CCS-området kolliderar med ett annat reserverat minnesområde.

    AI som verktyg – inte ansvarig utvecklare

    Händelsen visar både möjligheterna och begränsningarna med AI-baserad programmering. AI:n löste inte självständigt problemet och var flera gånger beredd att ge upp. Däremot kunde den snabbt producera diagnostisk kod och gå igenom stora mängder teknisk information när en erfaren utvecklare styrde arbetet.

    Det ligger nära Torvalds tidigare hållning: Linuxprojektet ska varken vara ett AI-projekt eller ett anti-AI-projekt. AI bör behandlas som vilket utvecklingsverktyg som helst. Det är fortfarande människan som använder verktyget som ansvarar för kodens kvalitet, granskar resultatet och ser till att ändringen är korrekt.

    Felsökningen av Intel Xe-drivrutinen är ett tydligt exempel på detta samspel. AI:n stod för mycket av uthållighetsarbetet, men det krävdes mänsklig envishet, teknisk erfarenhet och 18 kernelstarter för att nå fram.

    Efter 24 felsökningspatchar visade sig hela problemet i praktiken handla om skillnaden mellan att avrunda uppåt och att avrunda nedåt. I Linuxkärnan kan en enda felaktig avrundning vara skillnaden mellan ett fungerande skrivbord och en helt svart skärm.

    Källor: Kodändringen i Linuxkärnan och diskussionen på DRM-utvecklarnas e-postlista.

    > SYSTEMINFORMATION: INTEL_XE_DEBUG

    FAKTA // Linuxbuggen som krävde 18 omstarter

    $ berörd_drivrutin
    Intel Xe, grafikdrivrutinen i Linuxkärnan.
    $ symptom
    Svart skärm när GDM upprepade gånger försökte starta om skrivbordets kompositör.
    $ testad_hårdvara
    Intel Battlemage G21 med 16 GiB grafikminne.
    $ orsak
    En minnesgräns avrundades uppåt. Därför kunde en del av grafikminnet som var reserverat för kompressionsdata delas ut som vanligt, användbart minne.
    $ konsekvens
    Grafikkretsens kompressionshårdvara skrev över delar av Mesas sidtabell. GPU:n kunde då inte hitta kompositörens instruktioner.
    $ felsökning
    24 felsökningspatchar och 18 omstarter av Linuxkärnan.
    $ ai_roll
    AI hjälpte till att skriva diagnostisk kod, analysera resultaten och dokumentera felet. Linus Torvalds styrde arbetet och avgjorde vilka tester som skulle genomföras.
    $ lösning
    Gränsen ändrades från uppåtrundning till nedåtrundning, så att det reserverade CCS-minnet inte längre kunde lämnas ut till andra användare.
    > STATUS: BUGG IDENTIFIERAD OCH RÄTTAD
    > SLUTLIG ÄNDRING: round_up() → round_down()

    > Läs kodändringen på GitHub

  • GCC säger nej till betydande kod som skapats av AI

    Utvecklare får använda AI för att diskutera idéer, förstå källkod och göra efterforskningar. Men kod som helt eller delvis bygger på material från språkmodeller som ChatGPT, Gemini eller GitHub Copilot ska normalt inte tas emot som bidrag till GNU Compiler Collection.

    GCC Steering Committee, den grupp som leder utvecklingen av GNU Compiler Collection, har antagit en ny policy för användningen av artificiell intelligens och stora språkmodeller.

    GNU Compiler Collection, vanligtvis förkortat GCC, är en samling kompilatorer för bland annat programmeringsspråken C, C++, Fortran och Ada. Programvaran är en central del av många Linuxsystem och används för att omvandla programmerares källkod till körbara program.

    Den nya policyn innebär att GCC tills vidare kommer att avvisa bidrag som innehåller upphovsrättsligt betydande material som har skapats av en språkmodell.

    Det räcker inte att redigera AI-koden

    Reglerna omfattar inte bara kod som kopierats direkt från exempelvis ChatGPT eller GitHub Copilot. Även kod som senare har skrivits om, rättats eller förbättrats av en människa kan omfattas.

    Det avgörande är om den färdiga koden fortfarande bygger på material som ursprungligen skapades av en språkmodell.

    En utvecklare kan alltså inte låta en AI skapa en större funktion, städa upp koden manuellt och därefter behandla resultatet som ett helt självständigt arbete.

    När ett kodbidrag väl har sitt ursprung i AI-genererat material fortsätter det, enligt policyn, att räknas som härlett från detta material.

    AI får fortfarande användas som hjälpmedel

    Policyn innebär inte ett fullständigt förbud mot AI-verktyg.

    Utvecklare får fortfarande använda språkmodeller för att:

    • diskutera programmeringsidéer,
    • förstå befintlig källkod,
    • lära sig mer om ett obekant teknikområde,
    • undersöka möjliga lösningar,
    • genomföra allmän efterforskning.

    Begränsningen gäller när upphovsrättsligt betydande material från språkmodellen faktiskt hamnar i den kod som skickas in till GCC-projektet.

    En utvecklare kan exempelvis fråga en språkmodell hur en viss kompilatorteknik fungerar. Därefter kan utvecklaren själv konstruera och skriva en egen lösning. Det skiljer sig från att låta språkmodellen skapa själva implementationen och sedan använda den som grund för bidraget.

    Vad betyder upphovsrättsligt betydande?

    All kod är inte automatiskt tillräckligt originell eller omfattande för att skyddas av upphovsrätten.

    En mycket enkel ändring, som att rätta ett stavfel, byta ett variabelnamn eller justera en uppenbar felskrivning, kan vara juridiskt obetydlig. Mer omfattande funktioner, algoritmer och implementationer kan däremot betraktas som upphovsrättsligt betydande.

    Policyn innehåller därför vissa begränsade undantag.

    GCC:s ansvariga utvecklare kan acceptera triviala eller juridiskt obetydliga ändringar som har skapats med hjälp av en språkmodell. Ändringen måste fortfarande uppfylla projektets vanliga kvalitetskrav, och användningen av AI ska redovisas tydligt.

    Särskilda regler för testprogram

    AI-genererade testfall kan också behandlas annorlunda än kod som blir en permanent del av GCC.

    Ett testfall består ofta av ett mycket litet program som används för att återskapa ett fel eller kontrollera att kompilatorn beter sig på rätt sätt. Sådan kod är normalt inte en del av kompilatorns egen implementation.

    Därför kan även upphovsrättsligt betydande AI-genererade testfall i vissa situationer accepteras.

    Upphovsrätten är den stora frågan

    Bakgrunden till försiktigheten är osäkerheten kring hur språkmodeller har tränats och vilka rättigheter som gäller för materialet de producerar.

    En språkmodell kan ha tränats på stora mängder offentligt tillgänglig källkod. Det är inte alltid möjligt att avgöra om ett kodförslag är en helt ny konstruktion eller om det ligger nära kod som redan har skrivits av någon annan.

    För ett stort projekt som GCC kan detta skapa både juridiska och praktiska problem. Projektet måste kunna veta att den kod som tas emot får distribueras under GCC:s licens och att bidragsgivaren har rätt att lämna över den.

    En försiktighetsprincip för fri programvara

    Den nya policyn visar att AI kan användas som ett verktyg under utvecklingsarbetet, men att ansvaret fortfarande ligger hos människan.

    För GCC räcker det inte att en utvecklare förstår, granskar eller förbättrar den kod som en språkmodell har skapat. Om ett betydande kodbidrag bygger på AI-genererat material kan det fortfarande avvisas.

    Budskapet till utvecklare är därför tydligt: använd gärna AI för att lära, resonera och undersöka – men skriv den kod som ska skickas in till GCC själv.

    > FAKTA: GCC OCH AI-GENERERAD KOD

    GCC är en samling kompilatorer för bland annat C, C++, Fortran och Ada. GCC används i många Linuxdistributioner och andra fria operativsystem.

    GCC-projektets nya policy innebär att upphovsrättsligt betydande kod som har skapats av en språkmodell normalt inte accepteras som bidrag.

    Policyn gäller även kod som först har skapats av exempelvis ChatGPT, Gemini eller GitHub Copilot och därefter har skrivits om eller förbättrats av en människa.

    AI får fortfarande användas för att diskutera idéer, förstå befintlig kod, göra efterforskningar och lära sig mer om ett teknikområde.

    Triviala ändringar och vissa testfall kan i särskilda fall accepteras. Användningen av AI måste då redovisas tydligt.

    █
  • Linus Torvalds: Från programmerare till utvecklingsledare

    Linus Torvalds skriver numera sällan kod själv och beskriver sin roll som utvecklingsledare. Under Open Source Summit India 2026 berättade han om arbetet bakom Linuxkärnan, synen på AI och Rust samt varför föråldrad teknik ibland måste tas bort.

    Linus Torvalds skriver numera sällan kod själv. I stället leder han utvecklingen av Linuxkärnan genom att granska större förändringar, samordna utvecklare och fatta beslut om projektets inriktning.

    Under Open Source Summit India 2026 berättade han att Git och e-post fortfarande är hans viktigaste verktyg. Arbetet handlar i dag mer om människor, prioriteringar och helhet än om enskilda kodrader.

    Linux utvecklas stegvis, med nya kärnversioner ungefär varannan månad. Torvalds föredrar små förbättringar framför stora och riskfyllda förändringar. Han är särskilt försiktig med sena rättningar, eftersom även mindre ändringar kan skapa nya problem.

    Enligt Torvalds är mänskliga konflikter ofta svårare att lösa än tekniska fel. Kod kan rättas, medan problem med kommunikation och samarbete kan bli betydligt mer komplicerade.

    Han anser också att Linux inte kan stödja all gammal hårdvara för alltid. Teknik som inte längre används måste ibland tas bort för att minska mängden kod som behöver underhållas.

    Rust är enligt Torvalds ett viktigt tillskott, men inget fullständigt skydd mot fel. Språket kan förhindra vissa minnesproblem, men inte logiska misstag. Därför kommer C även fortsättningsvis att spela en viktig roll i Linuxkärnan.

    AI-verktyg används allt mer för att hitta buggar och granska kod. Samtidigt har de skapat felaktiga rapporter och ytliga lösningar. Torvalds anser därför att människor alltid måste kontrollera och ansvara för AI-genererade bidrag.

    Han använder själv AI för mindre experiment och prototyper, men anser ännu inte att tekniken är tillräckligt pålitlig för att självständigt skriva kod till Linuxkärnan.

    Torvalds främsta uppgift är numera inte att programmera, utan att se till att tusentals utvecklares arbete tillsammans leder till en stabil och långsiktigt hållbar Linuxkärna.

    https://www.zdnet.com/article/open-source-summit-linus-torvalds

  • Akrites ska hjälpa öppen källkod att hantera säkerhetshot snabbare

    När AI-verktyg gör det lättare att hitta säkerhetsbrister i öppen källkod ökar också trycket på de utvecklare som måste hantera rapporterna. Därför lanserar Linux Foundation initiativet Akrites, som ska samordna rapportering, åtgärder och offentliggörande av allvarliga sårbarheter i viktiga öppna projekt.

    Akrites ska hjälpa öppen källkod att hantera säkerhetshot snabbare

    Öppen källkod är en grundpelare i dagens digitala samhälle. Den används i allt från mobiltelefoner och molntjänster till banker, myndigheter, sjukhus och artificiell intelligens. Men när så många system bygger på samma öppna komponenter blir säkerheten också en gemensam angelägenhet.

    Linux Foundation har därför lanserat Akrites, ett nytt initiativ som ska förbättra hur allvarliga säkerhetsbrister i öppen källkod rapporteras, hanteras och åtgärdas.

    Bakom satsningen finns flera stora aktörer inom teknik, AI, finans och cybersäkerhet. Bland de medverkande finns bland annat Amazon Web Services, Anthropic, Google, Microsoft, GitHub, Red Hat, NVIDIA, OpenAI, Cisco, IBM, JPMorganChase, Rust Foundation och flera andra organisationer.

    AI hittar fler sårbarheter än tidigare

    En viktig bakgrund till Akrites är att AI-verktyg numera kan hjälpa säkerhetsforskare att hitta sårbarheter i kod mycket snabbare än förr. Det är i grunden positivt. Ju tidigare en brist upptäcks, desto snabbare kan den rättas till.

    Men den nya utvecklingen skapar också problem.

    Många projekt inom fri och öppen källkod drivs av små grupper eller enskilda frivilliga utvecklare. När de plötsligt får stora mängder säkerhetsrapporter kan det bli svårt att hinna kontrollera vilka rapporter som är riktiga, vilka som är dubbletter och vilka som faktiskt är allvarliga.

    Det räcker nämligen inte att bara hitta en sårbarhet. Den måste också bekräftas, bedömas, prioriteras, rättas i koden och ibland samordnas med flera leverantörer innan informationen blir offentlig. Om informationen sprids för tidigt kan angripare utnyttja bristen innan användarna hunnit uppdatera sina system.

    En gemensam säkerhetsgrupp

    Akrites är tänkt att fungera som ett samordnande lager mellan säkerhetsforskare, utvecklare, företag och organisationer. Initiativet ska bland annat skapa ett gemensamt Security Incident Response Team, alltså en grupp som kan hjälpa till vid allvarliga säkerhetsincidenter.

    Projektet ska också använda en standardiserad process för så kallad Coordinated Vulnerability Disclosure. Det betyder att information om sårbarheter hanteras på ett ansvarsfullt och samordnat sätt, så att utvecklare får möjlighet att rätta felet innan detaljerna sprids brett.

    Akrites ska arbeta med etablerade säkerhetsstandarder och verktyg, exempelvis CVE, CWE, CVSS, EPSS, SSVC och VEX. Dessa används för att beskriva, klassificera och prioritera säkerhetsbrister.

    Kan hjälpa övergivna projekt

    En särskilt intressant del av Akrites är att initiativet även kan fungera som en slags “sista utväg” för viktiga öppna projekt som saknar aktiva underhållare.

    Det är ett välkänt problem inom mjukvaruvärlden att många program och bibliotek fortsätter att användas långt efter att de ursprungliga utvecklarna slutat arbeta med dem. Trots det kan dessa komponenter finnas kvar i tusentals andra system.

    Om en allvarlig säkerhetsbrist upptäcks i ett sådant projekt kan det vara oklart vem som egentligen ska ta ansvar för att rätta felet. Där kan Akrites få en viktig roll.

    Upptäckt är bara första steget

    Säkerhet inom öppen källkod handlar inte bara om att hitta fel. Det handlar lika mycket om att ha fungerande rutiner för vad som händer efteråt.

    En sårbarhet måste analyseras. Hur allvarlig är den? Vilka system påverkas? Finns det redan ett angrepp i omlopp? Behöver ett CVE-nummer tilldelas? Ska informationen delas med leverantörer innan den blir offentlig?

    Det är just denna kedja som Akrites vill stärka.

    Om projektet fungerar som tänkt kan det minska mängden dubbla rapporter, förbättra samarbetet mellan utvecklare och företag samt göra att säkerhetsfixar når användarna snabbare.

    Ett viktigt steg för hela ekosystemet

    Öppen källkod bygger på samarbete. Men när mjukvaran används i samhällskritiska system krävs också tydliga strukturer för säkerhet och ansvar.

    Akrites kan därför bli ett viktigt komplement till andra säkerhetsinitiativ inom öppen källkod, till exempel OpenSSF och Alpha-Omega. Men framgången kommer inte bara att avgöras av vilka stora företag som står bakom projektet.

    Det avgörande blir om Akrites lyckas samarbeta med de människor som faktiskt underhåller den öppna koden. Om initiativet underlättar deras arbete, minskar belastningen och leder till snabbare säkerhetsuppdateringar kan det bli ett betydelsefullt steg framåt för hela den öppna mjukvaruvärlden.

    I en tid där AI både kan hjälpa till att hitta säkerhetsbrister och samtidigt öka mängden rapporter är behovet av samordning större än någonsin. Akrites är ett försök att skapa ordning i den nya verkligheten.

    https://www.linuxfoundation.org/press/linux-foundation-and-industry-leaders-launch-akrites-to-defend-critical-open-source-software-against-ai-enabled-cyber-threats

    Teknisk faktaruta: Akrites

    Namn: Akrites

    Organisation: Linux Foundation

    Syfte: Förbättra hantering, samordning och offentliggörande av säkerhetsbrister i öppen källkod.

    Fokusområde: Kritiska sårbarheter i viktiga open source-projekt.

    Bakgrund: AI-verktyg gör det möjligt att hitta fler sårbarheter snabbare, men många projekt saknar resurser för att hantera stora mängder säkerhetsrapporter.

    Arbetssätt: Samordnad sårbarhetsrapportering, verifiering, prioritering, åtgärd och ansvarsfull publicering.

    Standarder och verktyg: CVE, CWE, CVSS, EPSS, SSVC, VEX och TLP.

    Viktiga aktörer: AWS, Anthropic, Google, Microsoft, GitHub, Red Hat, NVIDIA, OpenAI, IBM, Cisco, Rust Foundation och flera andra.

    Betydelse: Akrites kan minska dubbla rapporter, förbättra samarbetet med utvecklare och göra att säkerhetsfixar når användare snabbare.

  • Darktable 5.6: öppen RAW-redigering får frivilliga AI-verktyg

    Darktable 5.6 är här med ett av programmets största teknikskiften hittills. Den fria RAW-redigeraren får nu frivilliga AI-verktyg för objektmasker, brusreducering och uppskalning – men utan att tvinga användaren in i ett AI-baserat arbetsflöde. Samtidigt bjuder versionen på HEIF-export, färgharmonisering, bättre prestanda, förbättrat gränssnitt och stöd för fler kameror.

    Darktable 5.6 har släppts och är en av de större uppdateringarna på länge för det fria och öppna RAW-redigeringsprogrammet. Programmet används av fotografer som vill arbeta med digitala negativ utan att vara beroende av kommersiella molntjänster eller prenumerationer. Den nya versionen innehåller förbättringar för bildkvalitet, arbetsflöde, export, prestanda och kamerastöd – men den mest uppmärksammade nyheten är ett nytt, frivilligt AI-system.

    Det viktiga ordet är just frivilligt. AI-funktionerna är avstängda som standard och måste aktiveras vid kompilering med byggflaggan -DUSE_AI=ON. Om AI-stödet inte aktiveras laddar Darktable inte in ONNX Runtime-bibliotek och utför heller inga AI-relaterade uppgifter. Det gör att användare som vill ha ett traditionellt, helt lokalt och resurssnålt bildflöde kan fortsätta använda programmet som tidigare.

    För den som väljer att aktivera AI-stödet öppnas däremot flera nya möjligheter. Darktable 5.6 kan då hantera och ladda ner AI-modeller från ett konfigurerbart modellförråd. Det finns även installationsskript för Linux och Windows som hjälper till att konfigurera GPU-acceleration för hårdvara från Nvidia, AMD och Intel. På macOS och många Windows-system ingår GPU-acceleration som standard.

    En av de mest praktiska nyheterna är AI-baserade objektmasker. Masker används i bildredigering för att påverka bara vissa delar av en bild, till exempel himlen, ett ansikte eller ett föremål i förgrunden. Med objektmasker kan det bli enklare att välja ut bildområden utan att rita varje markering för hand. För fotografer som ofta arbetar med lokala justeringar kan detta spara mycket tid.

    Darktable 5.6 får också en ny modul för neural återställning. Den finns i sidopanelen i både ljusbordet och mörkrummet och kan användas för tre AI-baserade uppgifter: brusreducering av RAW-bilder, vanlig bildbrusreducering och uppskalning. Standardmodellerna omfattar bland annat NIND UNet för brusreducering, RawNIND UtNet2 för RAW-brusreducering samt RealPLKSR i 2x och 4x för superupplösning. Ytterligare modeller, som NAFNet och BSRGAN, kan installeras manuellt.

    Det här betyder i praktiken att Darktable nu får verktyg som kan hjälpa till med några av de svåraste problemen i digital fotografering: brus i mörka bilder, detaljer som försvinner vid höga ISO-tal och bilder som behöver förstoras utan att tappa för mycket kvalitet. Samtidigt är lösningen byggd så att användaren själv väljer om AI-delen ska finnas med eller inte.

    En annan stor nyhet är modulen color harmonizer, eller färgharmonisering. Den arbetar i UCS-färgrymd och kan justera färger mot olika harmoniska strukturer, till exempel komplementfärger, delade komplementfärger, triader och tetrader. För den som inte arbetar dagligen med färgteori betyder det att programmet kan hjälpa till att skapa mer balanserade färgkombinationer i bilden. Modulen har även stöd för egna harmonier, där användaren kan ange egna ankarnoder, samt reglage för styrka, skydd av neutrala färger och mjukare övergångar.

    Exportmöjligheterna har också förbättrats. Darktable 5.6 får stöd för export till HEIF-formatet, ett modernt bildformat som ofta kan ge hög bildkvalitet vid mindre filstorlek än äldre format. Användaren kan välja mellan förlustfri och förstörande komprimering, olika färgdjup som 8, 10 och 12 bitar samt tillgängliga alternativ för färgsampling.

    Gränssnittet har fått flera förbättringar. Beskärningsmodulen visar nu både bildförhållande och dimensioner direkt i förhandsvisningen. En andra mörkrumsruta kan fästa bilder från filmremsan, vilket kan vara användbart vid jämförelsearbete. Det går också att växla mellan punkt- och områdesbaserad färgväljare direkt på arbetsytan med Ctrl-klick.

    För användare med stora bildskärmar och högupplösta arbetsflöden finns stöd för att rendera och cacha förhandsvisningar i 6K eller 8K i ljusbordsvyn. Mörkrummets förhandsvisningsupplösning har höjts från 720×450 till 1440×900, vilket ger bättre data till bland annat scopes och färgväljaren. Dessutom finns ett nytt 2-up-scope som visar både waveform och vectorscope samtidigt.

    Prestandan har förbättrats på flera områden. OpenCL-stödet för guided filtering har blivit snabbare genom intern tiling, modulen för oskärpa arbetar snabbare vid stora radier, och överläggsmodulen har fått en ny OpenCL-väg. Darktable kör också färre onödiga pixelpipe-beräkningar och hanterar maskdistorsion mer effektivt.

    Bland de övriga nyheterna finns stöd för Canon Automatic Lighting Optimizer i CR3-bilder, PNG- och vektoriseringsstöd för externa rastermasker, ett nytt filter för bilddubbletter, förbättrade standardvärden för AgX, förbättrade OpenCL-inställningar och nya HTJ2K-komprimeringsalternativ för EXR-export när programmet länkas mot OpenEXR 3.4 eller senare.

    Darktable 5.6 innehåller även stöd för fler kameror, bland annat Canon EOS Hi, Fujifilm X-T30 III, Hasselblad H4D-40, Hasselblad H6D-100c, Hasselblad X2D II 100C, Leica M Monochrom, flera Nikon Coolpix-modeller, Nikon D2X, Panasonic DC-GF90, Ricoh GR IV, Sony ILCE-7M5 och Sony ILME-FX2. Dessutom tillkommer nya vitbalansförinställningar och brusprofiler för flera kameramodeller.

    Som vanligt innehåller versionen också många buggfixar. Bland annat har problem med maskpositionering, färgprofiler, kortkommandon, OpenCL och CPU-baserad pixelpipe, taggning, geolokalisering, miniatyrbilder, ritade masker och demosaicing åtgärdats.

    Den som uppgraderar från Darktable 5.4 bör först säkerhetskopiera både konfiguration och bildbibliotek. När bibliotek och inställningar väl har uppdaterats av Darktable 5.6 är de inte längre kompatibla med version 5.4.

    Darktable 5.6 finns nu att ladda ner från projektets officiella webbplats och GitHub-sida. Det finns källkod, AppImage-versioner för Linux på x86_64 och aarch64, macOS-paket för både Intel och Apple Silicon samt Windows-installationsfiler för x86_64 och Windows on ARM.

    Med version 5.6 tar Darktable ett tydligt steg in i en tid där AI-verktyg blir allt vanligare även i fria bildprogram. Skillnaden är att användaren själv får välja. För vissa blir AI-stödet ett kraftfullt hjälpmedel för brusreducering, maskning och uppskalning. För andra är det lika viktigt att kunna fortsätta använda ett traditionellt, öppet och lokalt RAW-arbetsflöde utan AI. Det är just den valfriheten som gör Darktable 5.6 särskilt intressant.

    https://www.darktable.org/install

    Fakta: Darktable 5.6

    Program: Darktable

    Version: 5.6

    Typ av program: Fri och öppen RAW-redigerare för fotografer.

    Plattformar: GNU/Linux, macOS och Windows.

    Största nyheten: Ett frivilligt AI-system som är avstängt som standard och måste aktiveras manuellt vid byggning.

    Nya AI-funktioner: AI-baserade objektmasker, brusreducering, RAW-brusreducering och uppskalning av bilder.

    Ny bildmodul: Color Harmonizer, som kan justera färger enligt olika färgharmonier, exempelvis komplementära, triadiska och tetradiska färgscheman.

    Ny exportfunktion: Stöd för HEIF-export med både förlustfri och förlustgivande komprimering.

    Förbättrat gränssnitt: Bland annat förbättrad beskärningsvisning, kondenserat panel-läge, bättre färgväljare och stöd för högupplösta förhandsvisningar.

    Prestanda: Snabbare OpenCL-bearbetning, bättre hantering av stora radier i oskärpemodulen och effektivare maskhantering.

    Viktigt vid uppgradering: Säkerhetskopiera inställningar och bildbibliotek innan uppgradering, eftersom bibliotek som uppdateras till Darktable 5.6 inte är kompatibla med Darktable 5.4.

  • WordPress 7.0: När publiceringsverktyget tar första steget in i AI-eran

    WordPress 7.0: När publiceringsverktyget tar första steget in i AI-eran

    WordPress 7.0 markerar ett tydligt skifte för världens mest använda publiceringsplattform. Med nya AI-funktioner, en modernare administrationspanel och bättre verktyg för design, navigation och responsiv layout blir uppdateringen mer än en vanlig versionshöjning. WordPress tar nu ett steg mot en framtid där webbplatser kan byggas smartare, snabbare och mer visuellt – utan att användaren behöver vara utvecklare.

    WordPress har länge varit internets osynliga motor. Bakom bloggar, företagshemsidor, nyhetssajter, webbutiker och föreningssidor finns ofta samma grundsystem. Nu tar WordPress nästa stora steg med version 7.0, kallad Armstrong, en uppdatering som inte bara putsar på ytan utan också lägger grunden för hur artificiell intelligens kan bli en naturlig del av framtidens webbpublicering.

    Namnet Armstrong är en hyllning till jazzlegenden Louis Armstrong, musikern som förvandlade jazzen genom sitt personliga uttryck, sin trumpet och sin röst. På samma sätt vill WordPress 7.0 ge webbskapare fler verktyg för att sätta sin egen prägel på innehåll, design och arbetsflöden.

    AI flyttar in i WordPress

    Den största nyheten är att WordPress nu får en tydligare grund för AI-funktioner. I stället för att varje tillägg ska behöva bygga egna lösningar för att koppla upp sig mot externa AI-tjänster introduceras en mer standardiserad modell.

    En ny Connectors-skärm fungerar som en central plats där webbplatsägaren kan hantera kopplingar till externa tjänster, däribland AI-leverantörer. Det betyder att en användare i framtiden enklare kan välja vilken AI-tjänst som ska användas och sedan låta olika delar av WordPress dra nytta av samma anslutning.

    Med ett frivilligt AI-tillägg blir det möjligt att använda AI direkt i redigeraren. Systemet kan till exempel hjälpa till att generera rubriker, skriva utdrag, föreslå alt-texter till bilder, skapa bilder, redigera bilder och automatisera enklare arbetsmoment.

    För vanliga användare kan detta spara tid. För utvecklare innebär det att WordPress får en mer enhetlig teknisk grund för AI, i stället för att varje plugin behöver uppfinna sin egen lösning.

    En modernare administrationspanel

    WordPress administrationspanel har sett ganska likartad ut under lång tid. I version 7.0 görs ett större visuellt lyft. Gränssnittet får en lugnare, renare och modernare känsla med nytt färgschema, uppdaterade knappar, förbättrade formulärfält och mjukare övergångar mellan olika sidor i administrationen.

    Det handlar inte bara om kosmetik. För den som arbetar dagligen i WordPress kan små förändringar i gränssnittet göra stor skillnad. En tydligare panel, bättre kontraster och enklare navigering gör att arbetsflödet känns mindre rörigt.

    En ny genväg till kommandopaletten, via ⌘K eller Ctrl+K, gör det dessutom enklare att snabbt hitta funktioner utan att leta sig fram genom menyer.

    Bättre kontroll över menyer och navigation

    Navigationen på en webbplats är ofta avgörande för hur lätt besökaren hittar rätt. I WordPress 7.0 får webbplatsägare ett särskilt arbetsläge för att bygga mer avancerade navigationsöverlägg.

    Tidigare har menyer ofta varit ganska enkla listor med länkar. Nu blir det möjligt att skapa rikare navigationsytor med kolumner, större typografi, justeringar, mallar och egna layouter. Det gör att menyer kan bli mer som designade innehållsytor än bara tekniska länksamlingar.

    För webbplatser med många undersidor, tjänster eller kategorier kan detta bli en stor förbättring.

    Mönster blir enklare att hantera

    WordPress blockmönster är färdiga designsektioner som kan läggas in på en sida. I tidigare versioner kunde dessa ibland upplevas som svåra att redigera eftersom de bestod av flera kapslade block.

    I WordPress 7.0 beter sig mönster mer som ett enda sammanhållet block när de har lagts till på sidan. Det gör det lättare att byta text, bilder och grundläggande stil utan att behöva gräva sig ned i flera lager av block.

    För mer avancerade ändringar finns fortfarande möjligheten att redigera själva mönstret separat.

    Visuell versionshistorik

    En annan viktig nyhet är en mer visuell hantering av tidigare versioner av sidor och inlägg. WordPress 7.0 introducerar en tidslinje där användaren kan granska äldre versioner och se förändringar block för block.

    I praktiken blir det enklare att förstå vad som har ändrats, när det ändrades och vilken version man eventuellt vill återställa. Det är särskilt användbart på webbplatser där flera personer arbetar med samma innehåll.

    I stället för att bara jämföra textmassor får användaren en mer visuell bild av innehållets utveckling.

    Responsiv design direkt i blocken

    Dagens webbplatser måste fungera lika bra på mobil, surfplatta och dator. WordPress 7.0 ger bättre kontroll över vilka block som ska visas på olika skärmstorlekar.

    Det innebär att en webbplatsägare kan välja att visa visst innehåll på dator men dölja det på mobil, eller tvärtom. Det kan vara användbart för stora bildsektioner, avancerade layouter eller innehåll som behöver anpassas för små skärmar.

    Det här gör WordPress mer flexibelt för dem som vill bygga mobilanpassade sidor utan att behöva skriva egen CSS-kod.

    Typsnitt för alla teman

    Font Library, alltså WordPress inbyggda funktion för att hantera typsnitt, blir nu tillgänglig för fler typer av teman. Tidigare var funktionen främst kopplad till blockteman, men i WordPress 7.0 fungerar den även med klassiska och hybrida teman.

    Det gör att fler användare kan installera, ladda upp och hantera typsnitt direkt från WordPress, oavsett vilket tema webbplatsen använder.

    För många mindre webbplatsägare innebär detta att det blir enklare att skapa ett mer konsekvent visuellt uttryck utan att behöva ändra temafiler manuellt.

    Nya block och bättre designverktyg

    WordPress 7.0 innehåller också flera nya block och redigeringsförbättringar. Bland nyheterna finns bland annat ett ikonblock, som gör det möjligt att lägga till och formge ikoner direkt i innehållet.

    Det nämns även förbättringar kring gallerier, rubriker, brödsmulor och andra byggstenar som gör det lättare att skapa tydliga och visuellt genomarbetade sidor.

    Tillsammans gör detta blockredigeraren mer komplett. WordPress fortsätter därmed rörelsen bort från att vara ett enkelt bloggverktyg och vidare mot att vara ett fullskaligt visuellt publiceringssystem.

    Snabbare och smartare laddning

    Prestanda är en central fråga för alla webbplatser. En långsam sida riskerar både färre besökare och sämre placering i sökmotorer.

    WordPress 7.0 förbättrar hur bilder prioriteras vid laddning. Det är särskilt viktigt när bilder ligger dolda i exempelvis navigationsöverlägg eller interaktiva block men ändå påverkar hur webbläsaren bedömer sidans viktigaste resurser.

    Uppdateringen förbättrar också inläsning av blockspecifika stilmallar i klassiska teman och ger bättre stöd för skript som bygger på moderna script-moduler. Målet är att minska onödig blockering när sidan laddas.

    Tillgänglighet får fortsatt fokus

    Tillgänglighet är ett område där små detaljer kan göra stor skillnad. WordPress 7.0 innehåller förbättringar för bland annat mediehantering, röststyrning, färgkontraster i det nya administrationsgränssnittet och navigering i redigeraren.

    Det är viktigt eftersom WordPress används av allt från privatpersoner till myndigheter, företag och organisationer. Ett publiceringsverktyg som används av så många måste fungera för så många användare som möjligt.

    Vad betyder WordPress 7.0 i praktiken?

    För vanliga användare innebär WordPress 7.0 framför allt en modernare arbetsmiljö och fler kreativa verktyg. Det blir lättare att bygga snygga sidor, hantera typsnitt, arbeta med responsiv design och använda AI-stöd direkt i publiceringen.

    För utvecklare är den stora nyheten att WordPress får en tydligare teknisk grund för AI och externa tjänster. Det kan på sikt leda till kraftfullare tillägg, bättre integrationer och mer automatiserade arbetsflöden.

    För företag och webbplatsägare handlar uppdateringen om effektivitet. AI kan hjälpa till med innehåll, den nya adminpanelen gör arbetet smidigare och förbättrade designkontroller minskar behovet av specialkod.

    En ny riktning för WordPress

    WordPress 7.0 är inte bara ännu en versionsuppdatering. Det är ett tecken på vart hela plattformen är på väg. AI blir en del av publiceringsmiljön, designverktygen blir mer visuella och administrationen får en modernare känsla.

    Samtidigt finns WordPress traditionella styrka kvar: friheten att bygga allt från en enkel blogg till en avancerad företagswebbplats.

    Med Armstrong tar WordPress ett tydligt steg in i nästa fas. Precis som Louis Armstrong satte sin personliga prägel på jazzen vill WordPress 7.0 ge användarna fler möjligheter att skapa webbplatser med egen stil, eget uttryck och nya tekniska möjligheter.

    Faktaruta: WordPress 7.0

    Version: WordPress 7.0

    Kodnamn: Armstrong

    Fokus: AI-funktioner, modernare administrationspanel, förbättrade designverktyg och bättre responsiv kontroll.

    Ny AI-grund: WordPress får stöd för AI-kopplingar via en central hantering för externa tjänster och AI-leverantörer.

    För användare: Enklare verktyg för rubriker, utdrag, alt-texter, bildskapande och redigering.

    För utvecklare: Mer standardiserad hantering av externa tjänster och AI-integrationer.

    Designnyheter: Förbättrade block, navigationsöverlägg, visuell versionshistorik och bättre kontroll över hur innehåll visas på mobil, surfplatta och dator.

    Administration: Nytt färgschema, uppdaterade knappar, modernare formulärfält och smidigare övergångar i kontrollpanelen.

    Rekommendation: Ta alltid backup av webbplatsen innan du uppdaterar WordPress.

  • Firefox 148 ger användaren kontroll över AI

    I den nya versionen av Mozilla Firefox 148 tar Mozilla ett tydligt steg i AI-debatten. Istället för att smyga in artificiell intelligens som standard ger webbläsaren användaren full kontroll över vilka AI-funktioner som får användas – eller om de ska blockeras helt.

    En månad efter föregående version lanserar Mozilla en ny uppdatering av webbläsaren Mozilla Firefox. Version 148 introducerar en funktion som speglar en större teknisk och samhällelig diskussion: hur mycket kontroll ska användaren ha över artificiell intelligens i sina digitala verktyg?

    Den mest uppmärksammade nyheten är en helt ny panel i inställningarna kallad AI Controls. Här samlas alla AI-relaterade funktioner på ett och samma ställe, vilket gör dem enklare att överblicka och styra.

    AI är avstängt från början

    En central detalj är att AI-funktioner är blockerade som standard. Användaren möts av en tydlig knapp med möjligheten att blockera alla AI-förbättringar. Det innebär att varken nya eller befintliga AI-funktioner aktiveras utan aktivt samtycke.

    Detta skiljer sig från många andra teknikföretag som istället aktiverar AI automatiskt och låter användaren själv leta efter hur man stänger av den. Firefox 148 signalerar därmed en mer försiktig och användarcentrerad strategi.

    Lokala AI-modeller för bättre integritet

    En del av funktionerna bygger på så kallade lokala modeller. Små AI-modeller laddas ner till användarens dator och körs direkt där, istället för att skicka data till externa servrar.

    Exempel på sådana funktioner är:

    AI-genererad alt-text för bilder i den inbyggda PDF-läsaren
    Förslag på namn när man skapar flikgrupper
    Sammanfattade nyckelpunkter i länkförhandsvisningar

    Genom att bearbetningen sker lokalt minskar risken att känslig information delas med tredje part. Det är ett tekniskt val som kombinerar modern AI med ett starkt integritetsfokus.

    Integration med externa chattbotar

    Utöver lokala funktioner kan användaren även aktivera sidofältsintegrationer med externa AI-tjänster. Bland de tjänster som stöds finns lösningar från företag som Anthropic samt verktyg som ChatGPT, Microsoft Copilot, Google Gemini och Le Chat Mistral.

    Även här är principen densamma: inget aktiveras automatiskt. Användaren väljer själv om och vilka tjänster som ska användas.

    Förbättrad tillgänglighet i PDF-filer

    Firefox 148 innehåller också förbättrat stöd för skärmläsare när det gäller matematiska formler i PDF-dokument. För personer som är beroende av hjälpmedelsteknik innebär detta att matematiskt innehåll kan tolkas mer korrekt och begripligt.

    Det är en teknisk förbättring som kanske inte märks för alla, men som har stor betydelse för tillgängligheten.

    Uppdateringar för Android

    Android-versionen av webbläsaren har fått en omdesignad verktygsrad med modernare utseende och bättre möjligheter till anpassning. Dessutom har en ny funktion lagts till i snabbmenyn: Copy link text, vilket gör det enklare att kopiera själva länktexten istället för webbadressen.

    Nya säkerhetsverktyg för utvecklare

    För webbutvecklare innebär Firefox 148 stöd för Trusted Types API och Sanitizer API. Dessa tekniker hjälper till att motverka cross-site scripting-attacker, en av de vanligaste säkerhetsbrister som drabbar webbapplikationer.

    Genom att stödja dessa standarder bidrar webbläsaren till att göra framtidens webb mer motståndskraftig mot angrepp.

    Ett principiellt ställningstagande

    Firefox 148 är kanske inte en uppdatering som förändrar hur webben ser ut över en natt. Men den är principiellt intressant. I en tid då artificiell intelligens snabbt byggs in i nästan all mjukvara väljer Mozilla en modell där användaren står i centrum.

    AI erbjuds som ett verktyg, inte som en förutsättning. Och i en allt mer automatiserad digital värld kan just möjligheten att säga nej vara en av de mest betydelsefulla funktionerna.

    https://ftp.mozilla.org/pub/firefox/releases/148.0/linux-x86_64/sv-SE

    Teknisk faktaruta: Firefox 148
    Ny huvudfunktion
    AI Controls-panel i Inställningar för att hantera/blockera AI-funktioner.
    Standardläge
    AI-förbättringar blockerade som standard, kan aktiveras per funktion.
    On-device AI
    Vissa funktioner kan köra små lokala modeller för bättre integritet.
    Exempel på AI-funktioner
    • Alt-text för bilder i inbyggd PDF-visare
    • Förslag på namn för flikgrupper
    • Nyckelpunkter i länkförhandsvisningar
    • Sidofält med chattbot-integreringar
    Tillgänglighet
    Förbättrat skärmläsarstöd för matematiska formler i PDF.
    Android
    Ny verktygsrad + “Copy link text” i snabbmenyn.
    För utvecklare
    Stöd för Trusted Types API och Sanitizer API för bättre XSS-skydd.
  • Firefox får AI-nödbroms – total avstängning på väg

    Mozilla har tagit ett ovanligt tydligt ställningstagande i AI-debatten. Med en ny ”AI Kill Switch” i Firefox ger företaget användarna full kontroll över vilka – om några – AI-funktioner som ska finnas i webbläsaren, ett drag som markerar en kursändring efter växande kritik från trogna Firefox-användare.

    Mozilla har nu tagit ett tydligt steg för att möta kritik från användare som vill slippa AI-funktioner i webbläsaren. Med den senaste uppdateringen av Firefox Nightly har företaget infört en efterlängtad AI Kill Switch – ett centralt reglage som gör det möjligt att helt stänga av alla AI-baserade funktioner i Firefox. Funktionen väntas bli tillgänglig för alla användare i samband med lanseringen av Firefox 148 i februari 2026.

    Bakgrund: ökande AI-kritik från användare

    Redan i december 2025, när Mozilla presenterade sin nya vd, stod det klart att bolaget var medvetet om det växande missnöjet bland delar av Firefox användarbas. Under flera versioner hade webbläsaren fått allt fler AI-drivna funktioner, något som av vissa upplevdes som påtvingat och i strid med Firefox traditionella fokus på kontroll, integritet och öppenhet.

    Löftet från Mozilla var tydligt: användarna skulle få makten att helt stänga av AI.

    AI Controls – ett samlat reglage i inställningarna

    Den nya lösningen kallas AI Controls och har fått en egen sektion i Firefox inställningar. Där finns reglaget “Block AI Enhancements”, som vid aktivering stänger av både befintliga och framtida AI-funktioner.

    Enligt beskrivningen innebär detta att användaren inte längre får se AI-relaterade funktioner – och inte heller popup-meddelanden eller marknadsföring kring dem. Reglaget länkar även till en informationssida som förklarar skillnaden mellan traditionell maskininlärning och de nyare AI-funktionerna.

    Funktioner som stängs av

    När AI-förbättringar blockeras inaktiveras bland annat:

    • Automatiska översättningar
    • Bildbeskrivningar (alt-text) i PDF-visaren
    • Förslag på flikgrupper
    • Sammanfattningar och nyckelpunkter i länkförhandsvisningar
    • AI-baserade chattbotar i sidopanelen

    Även tillägg som bygger på Firefox inbyggda AI-funktioner påverkas och blockeras.

    Möjlighet till selektiv kontroll

    Trots namnet är AI Kill Switch inte ett allt-eller-inget-val. Efter att ha blockerat AI globalt kan användaren välja att återaktivera enskilda funktioner via On-Device AI-inställningarna. Det går även att begränsa AI-användningen utan att slå på huvudreglaget, samt att välja vilken – om någon – AI-chattbot som ska visas i sidofältet.

    Så testar du funktionen redan nu

    AI Controls är ännu inte aktiverat som standard i Nightly. För att testa krävs att inställningen
    browser.preferences.aiControls
    ändras från false till true via about:config.

    Firefox 148 – fler nyheter än AI

    Utöver AI-kontrollerna innehåller Firefox 148 flera tekniska förbättringar. Mozilla utlovar bättre stöd för skärmläsare, WebGPU i service workers, stöd för Sanitizer API för säkrare HTML-manipulation samt Trusted Types API, som ska minska risken för cross-site scripting-attacker.

    AI-nödbromsen är utan tvekan den mest uppmärksammade nyheten – men Firefox 148 ser ut att bli en viktig version även ur ett bredare säkerhets- och tillgänglighetsperspektiv.

    Läs mer på Firefox hemsida

    FAKTA
    Firefox 148: AI Kill Switch (AI Controls)
    Ny funktion: ”Block AI Enhancements” stänger av AI-funktioner och AI-popups i Firefox.
    Finns i: Firefox Nightly (kräver aktivering via about:config).
    Så aktiverar du i Nightly: Sätt browser.preferences.aiControls = true.
    Exempel på AI som blockeras: översättningar, alt-text i PDF-visaren, flikgruppsförslag, nyckelpunkter i länkförhandsvisningar, chattbotar i sidopanelen.
    Selektiv kontroll: AI kan senare slås på per funktion via On-Device AI-inställningarna.
    Planerad release: Firefox 148 (förväntad 24 februari 2026).

Etikett: artificiell intelligens

  • AI-robotar pressar Kernel.org – miljontals automatiska anrop varje dag

    Kernel.org, en av de viktigaste infrastrukturerna bakom utvecklingen av Linux, utsätts för miljontals automatiska förfrågningar varje dygn. En stor del tros komma från AI-relaterade insamlingsrobotar. Nu går omkring en femtedel av serverkapaciteten åt till att hantera trafiken. Linux utvecklas helt öppet. Källkod, ändringar, diskussioner och historik finns tillgängliga för vem som helst att läsa och…

  • AI hjälpte Linus Torvalds hitta Linuxbugg efter 18 omstarter

    Ett avrundningsfel på en enda kodrad gjorde delar av ett reserverat grafikminne tillgängligt för vanliga program. Resultatet blev skadade data och svart skärm. För att hitta orsaken tog Linus Torvalds hjälp av AI – men det krävdes 24 felsökningspatchar och 18 omstarter innan gåtan var löst. AI används i allt fler delar av programutvecklingen, och…

  • GCC säger nej till betydande kod som skapats av AI

    Utvecklare får använda AI för att diskutera idéer, förstå källkod och göra efterforskningar. Men kod som helt eller delvis bygger på material från språkmodeller som ChatGPT, Gemini eller GitHub Copilot ska normalt inte tas emot som bidrag till GNU Compiler Collection. GCC Steering Committee, den grupp som leder utvecklingen av GNU Compiler Collection, har antagit…

  • Linus Torvalds: Från programmerare till utvecklingsledare

    Linus Torvalds skriver numera sällan kod själv och beskriver sin roll som utvecklingsledare. Under Open Source Summit India 2026 berättade han om arbetet bakom Linuxkärnan, synen på AI och Rust samt varför föråldrad teknik ibland måste tas bort. Linus Torvalds skriver numera sällan kod själv. I stället leder han utvecklingen av Linuxkärnan genom att granska…

  • Akrites ska hjälpa öppen källkod att hantera säkerhetshot snabbare

    När AI-verktyg gör det lättare att hitta säkerhetsbrister i öppen källkod ökar också trycket på de utvecklare som måste hantera rapporterna. Därför lanserar Linux Foundation initiativet Akrites, som ska samordna rapportering, åtgärder och offentliggörande av allvarliga sårbarheter i viktiga öppna projekt. Akrites ska hjälpa öppen källkod att hantera säkerhetshot snabbare Öppen källkod är en grundpelare…

  • Darktable 5.6: öppen RAW-redigering får frivilliga AI-verktyg

    Darktable 5.6 är här med ett av programmets största teknikskiften hittills. Den fria RAW-redigeraren får nu frivilliga AI-verktyg för objektmasker, brusreducering och uppskalning – men utan att tvinga användaren in i ett AI-baserat arbetsflöde. Samtidigt bjuder versionen på HEIF-export, färgharmonisering, bättre prestanda, förbättrat gränssnitt och stöd för fler kameror. Darktable 5.6 har släppts och är…

  • WordPress 7.0: När publiceringsverktyget tar första steget in i AI-eran

    WordPress 7.0: När publiceringsverktyget tar första steget in i AI-eran WordPress 7.0 markerar ett tydligt skifte för världens mest använda publiceringsplattform. Med nya AI-funktioner, en modernare administrationspanel och bättre verktyg för design, navigation och responsiv layout blir uppdateringen mer än en vanlig versionshöjning. WordPress tar nu ett steg mot en framtid där webbplatser kan byggas…

  • Firefox 148 ger användaren kontroll över AI

    I den nya versionen av Mozilla Firefox 148 tar Mozilla ett tydligt steg i AI-debatten. Istället för att smyga in artificiell intelligens som standard ger webbläsaren användaren full kontroll över vilka AI-funktioner som får användas – eller om de ska blockeras helt. En månad efter föregående version lanserar Mozilla en ny uppdatering av webbläsaren Mozilla…

  • Firefox får AI-nödbroms – total avstängning på väg

    Mozilla har tagit ett ovanligt tydligt ställningstagande i AI-debatten. Med en ny ”AI Kill Switch” i Firefox ger företaget användarna full kontroll över vilka – om några – AI-funktioner som ska finnas i webbläsaren, ett drag som markerar en kursändring efter växande kritik från trogna Firefox-användare. Mozilla har nu tagit ett tydligt steg för att…