• Pulsar 1.133 släppt – snabbare kodredigering och förbättrad terminal i Atoms efterföljare

    Den öppna källkodsredigeraren Pulsar har släppts i version 1.133. Uppdateringen innehåller en förbättrad terminal, snabbare hantering av stora filer och en omarbetad funktion för att övervaka filändringar. Samtidigt förbereder utvecklarna ett större teknikskifte som bland annat ska ge bättre stöd för Wayland på Linux.
    När GitHub lade ned utvecklingen av den populära kodredigeraren Atom i slutet av 2022 såg det ut som slutet för ett verktyg som hade blivit uppskattat av många programmerare.

    Men eftersom Atom byggde på öppen källkod kunde andra utvecklare ta över arbetet. Resultatet blev Pulsar, ett projekt som drivs av en grupp frivilliga utvecklare och entusiaster.

    Pulsar bygger vidare på Atoms grundidé: en flexibel och anpassningsbar kodredigerare där användaren själv kan installera tillägg, ändra utseendet och skapa en arbetsmiljö som passar de egna behoven.

    Med version 1.133 fortsätter projektet att modernisera programmet, samtidigt som man försöker behålla det som gjorde Atom populärt.

    Terminalen blir en naturligare del av kodredigeringen

    En av de viktigaste nyheterna handlar om Pulsars inbyggda terminal, som introducerades i version 1.132.

    En terminal är ett textbaserat gränssnitt där användaren kan skriva kommandon till operativsystemet. För programmerare är den ett viktigt arbetsredskap, exempelvis för att kompilera program, hantera Git eller köra olika utvecklingsverktyg.

    Tidigare behövde användare ofta växla mellan kodredigeraren och ett separat terminalfönster. Med en integrerad terminal kan arbetet i större utsträckning utföras direkt i samma program.

    I Pulsar 1.133 har terminalen fått stöd för OSC 8, en standard som gör det möjligt att visa klickbara hyperlänkar direkt i terminaltext.

    Det innebär exempelvis att ett kommandoradsprogram kan presentera en länk med ett beskrivande namn i stället för att skriva ut en lång webbadress.

    Användaren kan dessutom hålla muspekaren över länken för att se vart den leder innan den öppnas.

    Terminalen håller reda på vilken katalog du arbetar i

    En annan förbättring är att Pulsars terminal numera kan följa användarens aktuella arbetskatalog.

    Funktionen använder integration med kommandotolkar som Bash, Zsh, Fish och PowerShell.

    När användaren byter katalog uppdateras terminalflikens titel automatiskt för att visa den nya platsen.

    Om terminalen delas upp i flera paneler kan den nya panelen dessutom starta i samma katalog som den ursprungliga terminalen.

    Det kan låta som en liten förändring, men för utvecklare som arbetar med stora projekt och många kataloger innebär det färre onödiga moment.

    Terminalen känner också igen sökvägar till filer i kommandoutskrifter. Både absoluta och relativa sökvägar kan göras klickbara.

    Om exempelvis ett verktyg för kodanalys rapporterar ett fel i en viss fil kan programmeraren klicka på filnamnet och öppna den direkt i redigeraren.

    På Linux och Windows har terminalen dessutom fått stöd för tangentkombinationerna Ctrl+Shift+C och Ctrl+Shift+V för kopiering och inklistring.

    Slut på irriterande fördröjningar i stora filer

    En viktig prestandaförbättring gäller hanteringen av stora källkodsfiler.

    I Pulsar 1.127 introducerades ett problem med syntaxmarkeringen som kunde orsaka märkbara fördröjningar när användaren redigerade större filer.

    Syntaxmarkering är funktionen som färglägger olika delar av programkoden, exempelvis variabler, funktioner och kommentarer.

    Det hjälper programmeraren att snabbt förstå kodens struktur och upptäcka fel.

    Men eftersom redigeraren måste analysera texten medan användaren skriver kan ineffektiv syntaxmarkering påverka prestandan.

    I Pulsar 1.133 har utvecklarna rättat problemet, vilket ska göra arbetet med stora filer betydligt smidigare.

    Ny teknik övervakar ändringar i filsystemet

    En av de mer omfattande tekniska förändringarna finns under programmets yta.

    Pulsar använder en funktion som brukar kallas file watching, eller filövervakning.

    Den innebär att redigeraren håller reda på när filer ändras, flyttas eller tas bort från datorns lagringsenhet.

    Funktionen är särskilt viktig när flera program arbetar med samma filer, exempelvis när Git uppdaterar ett projekt eller ett externt byggverktyg genererar ny kod.

    I version 1.133 har arkitekturen för filövervakningen byggts om.

    Vid sidan av den befintliga lösningen nsfw kan användaren nu välja biblioteket @parcel/watcher, som även används av Visual Studio Code.

    Det alternativa biblioteket erbjuder bland annat bättre hantering av filer som ska ignoreras och vissa mer komplicerade situationer i filsystemet.

    En annan viktig förändring är att filövervakningen nu körs i en separat process i stället för direkt i Electrons renderingsprocess.

    Genom att skilja dessa funktioner åt minskar risken att problem med filövervakningen påverkar hela redigeraren.

    Det befintliga alternativet nsfw är fortfarande standard, men användaren kan byta mellan lösningarna utan att behöva starta om Pulsar.

    Bättre kontroll när filer raderas

    Pulsar har också blivit bättre på att hantera filer som tas bort utanför redigeraren.

    Tidigare kunde programmet behandla en raderad fil ungefär som en fil som hade ändrats på disken.

    Nu finns ett separat tillstånd för filer som har raderats från lagringsenheten men fortfarande är öppna i redigeraren.

    Det gör att programmet tydligare kan skilja mellan en ändrad fil och en fil som inte längre finns kvar.

    En ny inställning gör det också möjligt att stänga sådana filer utan extra bekräftelse, förutsatt att de inte innehåller osparade ändringar.

    Uppgradering till Electron 32

    Pulsar är byggt med Electron, ett ramverk som gör det möjligt att skapa skrivbordsprogram med webbtekniker som HTML, CSS och JavaScript.

    Electron kombinerar bland annat Chromium, tekniken bakom webbläsaren Google Chrome, med JavaScript-miljön Node.js.

    I Pulsar 1.133 har ramverket uppgraderats till Electron 32.3.3.

    Det innebär att redigeraren får tillgång till nyare komponenter och förbättringar i den underliggande tekniken.

    Uppgraderingen markerar samtidigt slutet för stödet till macOS 10.15 Catalina. Pulsar 1.133 blir den sista versionen som fungerar med detta äldre Apple-operativsystem.

    Nästa version får inbyggt stöd för Wayland

    För Linuxanvändare finns en särskilt intressant nyhet längre fram.

    Utvecklarna har meddelat att kommande Pulsar 1.134 ska uppgraderas till Electron 37.

    Den förändringen ska också ge programmet inbyggt stöd för Wayland, den moderna teknik som i allt större utsträckning ersätter det traditionella X11-systemet på Linuxskrivbord.

    Wayland ansvarar för kommunikationen mellan grafiska program och bildskärmen och används numera som standard i flera större Linuxdistributioner.

    I dag kan Electronbaserade program ibland behöva särskilda startparametrar för att använda Wayland direkt.

    Med den planerade uppgraderingen ska Pulsar kunna använda Wayland utan att användaren behöver ange parametern --ozone-platform.

    Det är ett viktigt steg för att göra programmet bättre anpassat till moderna Linuxmiljöer.

    Förbättrat stöd för flera programmeringsspråk

    Utöver de större förändringarna innehåller Pulsar 1.133 ett antal mindre förbättringar.

    Syntaxmarkeringen har bland annat förbättrats för Python, Perl och C#.

    För Python gäller förändringarna bland annat vissa typer av strängar med inbäddade uttryck, medan Perl får bättre stöd för modern klassyntax.

    Utvecklarna har också rättat ovanliga krascher kopplade till filövervakningen och Git-integrationen.

    Pulsars pakethanterare, som används för att installera och administrera tillägg, har uppdaterats till Node.js 20.18.1 och fått flera fel- och säkerhetsrättningar.

    Ett alternativ för den som saknar Atom

    Pulsar konkurrerar med betydligt större projekt som Visual Studio Code, men har samtidigt en egen position bland kodredigerare.

    För den som uppskattade Atoms gränssnitt och möjligheter till anpassning erbjuder Pulsar ett sätt att fortsätta använda en liknande arbetsmiljö utan att vara beroende av ett nedlagt projekt.

    Version 1.133 visar också att utvecklingen inte enbart handlar om att hålla gammal programvara vid liv.

    Genom förbättrad prestanda, modernare terminalfunktioner och en stabilare arkitektur fortsätter utvecklarna att bygga vidare på programmets funktionalitet.

    Den kommande övergången till Electron 37 och inbyggt Wayland-stöd blir ytterligare ett viktigt steg i moderniseringen.

    Pulsar 1.133 finns tillgängligt som öppen källkod och kan hämtas kostnadsfritt från projektets officiella webbplats: https://pulsar-edit.dev/
    developer@linux:~$ pulsar –version
    > PULSAR 1.133_
    OPEN SOURCE CODE EDITOR
    Program:
    Pulsar
    Version:
    1.133
    Programtyp:
    Källkodsredigerare
    Ursprung:
    Vidareutveckling av Atom
    Plattformar:
    Linux, Windows, macOS
    Ramverk:
    Electron 32.3.3
    Terminal:
    Integrerad med OSC 8-stöd
    Kommandotolkar:
    Bash, Zsh, Fish, PowerShell
    Filövervakning:
    nsfw / @parcel/watcher
    Pakethanterare:
    Node.js 20.18.1
    Licens:
    Öppen källkod (MIT)
    Pris:
    Kostnadsfritt
    > NYHETER I VERSION 1.133
    [OK] Förbättrad integrerad terminal
    [OK] Klickbara länkar och filsökvägar
    [OK] Snabbare redigering av stora filer
    [OK] Ny arkitektur för filövervakning
    [OK] Förbättrad syntaxmarkering
    [OK] Rättningar för Git och filhantering
    UPCOMING RELEASE:
    > Pulsar 1.134 – Electron 37 och inbyggt Wayland-stöd
    developer@linux:~$ pulsar-edit.dev █
  • Moxnox 1.0 – ett nytt operativsystem som förenar Windows NT och Unix

    Vad händer om man tar några av de bästa idéerna från Windows NT, kombinerar dem med Unix och bygger ett helt nytt operativsystem från grunden? Det är precis vad utvecklaren Mark Harmstone har gjort. Resultatet heter Moxnox, och nu har version 1.0 släppts som öppen källkod.

    När man talar om operativsystem handlar diskussionen nästan alltid om Windows, Linux eller macOS. Men bakom dessa välkända namn finns en värld av experimentella system där programmerare försöker hitta nya sätt att få datorer att fungera.

    Ett av de senaste exemplen är Moxnox 1.0, som släpptes den 26 oktober 2026.

    Bakom projektet står den brittiske programmeraren Mark Harmstone, som tidigare gjort sig känd genom WinBtrfs, en drivrutin som gör det möjligt för Windows att läsa och skriva till Linux-filsystemet Btrfs.

    Sedan 2022 har han arbetat med Moxnox som ett hobbyprojekt. Det som började som ett tekniskt experiment har nu vuxit till ett operativsystem med omkring 130 000 rader C++-kod.

    Men Moxnox är varken ännu en Linuxdistribution eller en kopia av Windows.

    Windows under huven – Unix på utsidan

    För att förstå vad som gör Moxnox speciellt behöver vi titta på hur ett operativsystem egentligen fungerar.

    I centrum finns operativsystemets kärna, ofta kallad kernel. Den ansvarar för grundläggande funktioner som att hantera minne, kommunicera med hårdvara och fördela processortid mellan olika program.

    Windows bygger på en kärnarkitektur som har sitt ursprung i Windows NT, medan Linux använder en annan konstruktion.

    Moxnox hämtar inspiration från Windows NT:s sätt att låta program kommunicera med operativsystemet genom så kallade systemanrop.

    Samtidigt använder det många av de principer som gjort Unix och Linux populära bland programmerare och systemadministratörer.

    Det innebär exempelvis att katalogstrukturen påminner om Linux, med en rotkatalog som heter / och sökvägar som /bin i stället för Windows enhetsbokstäver som C:\.

    Systemet stöder dessutom Unix-funktioner som fork(), som gör det möjligt för ett program att skapa en ny process genom att kopiera en befintlig.

    Man kan beskriva Moxnox som ett försök att förena två olika operativsystemfilosofier, utan att behöva använda vare sig Windows eller Linux som grund.

    Windows-program fungerar inte – trots EXE-filer

    En intressant detalj är att Moxnox använder samma grundläggande programformat som Windows.

    Körbara program lagras i formatet Portable Executable, förkortat PE, och har filändelsen .exe. Programbibliotek använder .dll.

    Linux använder normalt ELF-formatet för sina körbara program.

    Det betyder däremot inte att man kan installera Microsoft Office eller andra vanliga Windowsprogram i Moxnox.

    Moxnox kan i dagsläget inte köra vanliga Windowsprogram.

    Anledningen är att de programmeringsgränssnitt och systembibliotek som Windowsprogram förväntar sig ännu inte finns på plats.

    En framtida möjlighet skulle kunna vara att använda delar av Wine-projektet för att skapa denna kompatibilitet, men något sådant stöd är ännu inte färdigt.

    Moxnox skiljer sig därmed från ReactOS, vars ambition är att återskapa Windows kompatibilitet.

    Linuxanvändare kommer att känna igen sig

    Trots sin Windowsinspirerade teknikmiljö erbjuder Moxnox en ganska välbekant upplevelse för den som är van vid Unix eller Linux.

    Flera populära program har redan anpassats till systemet.

    Här finns bland annat Bash, GNU Coreutils, Git, Python, Perl, Vim, Nano, OpenSSH och OpenSSL.

    Även viktiga utvecklingsverktyg som GCC, LLVM och Rust har porterats, även om det fortfarande finns begränsningar. GCC finns exempelvis endast för x86-64.

    Att programmen har porterats innebär att deras källkod har anpassats och kompilerats för det nya operativsystemet. Man kan alltså inte bara kopiera över ett vanligt Linuxprogram och förvänta sig att det fungerar.

    En annan teknisk milstolpe är att Moxnox har blivit self-hosting.

    Det innebär att operativsystemet har kommit så långt att det kan användas för att kompilera sin egen källkod.

    Det är en betydande prestation för ett hobbyprojekt, även om vissa stora program, bland annat GCC och Rust, ännu inte kan byggas direkt inifrån systemet.

    Btrfs är hjärtat i filhanteringen

    Valet av filsystem är knappast någon överraskning.

    Mark Harmstone har lång erfarenhet av Btrfs genom arbetet med WinBtrfs, och Moxnox använder därför Btrfs för lagringen.

    Btrfs är ett modernt filsystem som bland annat erbjuder kontrollsummor för dataintegritet, ögonblicksbilder och avancerade lagringsfunktioner.

    Men här kommer en viktig varning.

    Moxnox egen Btrfs-implementation är fortfarande experimentell och har inte genomgått omfattande tester.

    Utvecklaren avråder uttryckligen från att använda den tillsammans med filsystem som innehåller värdefulla data.

    Den som vill experimentera bör därför använda en virtuell disk eller en separat lagringsenhet utan viktig information.

    Fungerar även på ARM och Raspberry Pi 5

    Moxnox stöder två olika processorarkitekturer: x86-64, som används i de flesta moderna PC-datorer, och ARM64, som bland annat förekommer i enkortsdatorer och vissa bärbara datorer.

    För vanliga PC-datorer krävs stöd för instruktionsuppsättningen x86-64-v3. Det innebär att en del äldre 64-bitarsprocessorer inte kan användas.

    På ARM-sidan krävs ARMv8.1 eller senare.

    Det gör att även Raspberry Pi 5 kan köra Moxnox, förutsatt att den använder lämplig UEFI-firmware.

    Systemet har redan drivrutiner för bland annat NVMe, SATA, USB-lagring, SD-kort och vissa nätverkskort från Realtek.

    Stödet för kringutrustning är dock långt ifrån lika omfattande som i Linux eller Windows.

    Glöm skrivbordet – här är det terminalen som gäller

    Den som förväntar sig ett grafiskt skrivbord med fönster, ikoner och muspekare kommer att bli besviken.

    Moxnox 1.0 saknar nämligen en grafisk skrivbordsmiljö.

    Systemet arbetar framför allt med textbaserade gränssnitt och kommandoraden. Det finns grundläggande stöd för bildskärmsutmatning, men ännu inget färdigt grafiskt användargränssnitt.

    Det är med andra ord ett operativsystem som i första hand riktar sig till programmerare, operativsystemsentusiaster och personer som tycker om att experimentera med datorernas mer grundläggande funktioner.

    Det saknas dessutom flera saker som vi normalt tar för givna.

    Exempelvis finns ännu inget fullständigt säkerhetssystem, inget riktigt fleranvändarstöd och inget ordentligt stöd för olika tangentbordslayouter eller tidszoner.

    Även prestandan behöver förbättras, framför allt när det gäller minneshantering och nätverkskommunikation.

    Moxnox är därför inte ett system som man bör använda som sin huvudsakliga arbetsmiljö.

    Så kan du prova Moxnox själv

    För den som är nyfiken finns färdiga diskavbilder för både x86-64 och ARM64 att ladda ner.

    Det enklaste sättet att testa operativsystemet är med QEMU, en programvara som kan emulera och virtualisera datorer.

    På så vis kan man starta Moxnox i en virtuell miljö utan att behöva installera det på datorns riktiga hårddisk.

    Det går också att installera systemet på fysisk hårdvara, men då krävs viss erfarenhet av partitionering, filsystem och uppstart via UEFI.

    Källkoden och installationsanvisningarna finns på projektets GitHub-sida:

    Projekt: https://github.com/maharmstone/moxnox

    Ladda ner Moxnox 1.0: https://github.com/maharmstone/moxnox/releases/tag/v1.0

    Varför behövs ännu ett operativsystem?

    Det är kanske den mest intressanta frågan.

    Världen lider knappast brist på operativsystem. Linux är etablerat inom servrar och utveckling, Windows dominerar fortfarande stora delar av PC-marknaden och macOS har sin självklara plats i Apples ekosystem.

    Men Moxnox handlar inte i första hand om att konkurrera med dessa system.

    Det handlar snarare om att utforska alternativa tekniska lösningar och visa att det går att kombinera idéer som traditionellt hör hemma i olika operativsystem.

    Windows NT:s arkitektur har flera tekniska egenskaper som sällan uppmärksammas utanför Windowsvärlden. Genom att kombinera dessa med Unix programmeringsmodell visar Harmstone hur ett annorlunda operativsystem skulle kunna se ut.

    Och kanske är det just därför Moxnox är intressant.

    Inte för att det kommer att ersätta Windows eller Linux nästa år, utan för att det påminner oss om att operativsystem inte behöver byggas på samma sätt som de alltid har gjort.

    Moxnox 1.0 är ännu inte ett färdigt alternativ för vanliga datoranvändare. Men som tekniskt experiment visar det hur mycket som faktiskt går att åstadkomma när någon bestämmer sig för att bygga sitt eget operativsystem från grunden.

    ● ● ●

    > FAKTA: MOXNOX 1.0_

    System: Moxnox 1.0

    Utvecklare: Mark Harmstone

    Typ: Fristående operativsystem med öppen källkod

    Projektstart: 2022

    Programspråk: C++ (cirka 130 000 kodrader)

    Arkitektur: Windows NT-inspirerade systemanrop och Unix/POSIX-miljö

    Processorstöd: x86-64-v3 och ARM64 (ARMv8.1+)

    Filsystem: Btrfs

    Programformat: Windows PE (.exe och .dll)

    Gränssnitt: Textbaserad terminal, inget grafiskt skrivbord

    Programvara: Bash, GCC, LLVM, Git, Python, Perl, Rust, Vim, Nano och OpenSSH

    Hårdvara: NVMe, SATA, USB, SD-kort och utvalda nätverkskort

    Raspberry Pi 5: Stöds med lämplig UEFI-firmware

    Windowsprogram: Kan inte köras direkt

    Status: Experimentellt hobbyprojekt

    [!] VARNING: Moxnox är inte avsett för produktionsbruk. Använd endast testdiskar utan viktiga data.

    root@moxnox:~$ GitHub / Källkod

    root@moxnox:~$ Ladda ner Moxnox 1.0

  • Lightpanda 1.0 är här – webbläsaren som inte behöver visa webbsidor

    En webbläsare som inte kan visa webbsidor på skärmen låter kanske som en ganska meningslös uppfinning. Men Lightpanda är byggd för en helt annan uppgift: att låta datorer och AI-system använda internet snabbt och resurssnålt. Nu har projektet nått version 1.0 och lämnat betastadiet efter två års utveckling.

    Den 2 oktober 2026 presenterades den första stabila versionen av Lightpanda. Bakom programmet ligger ett utvecklingsarbete som omfattar över 10 000 kodändringar och ett försök att tänka om kring vad en webbläsare egentligen behöver göra.

    Medan traditionella webbläsare som Chrome och Firefox är utvecklade för människor, är Lightpanda konstruerad för program som automatiskt ska kunna besöka och använda webbplatser.

    Resultatet är en webbläsare som enligt utvecklarnas egna tester kan vara upp till nio gånger snabbare än Chrome och använda omkring sexton gånger mindre arbetsminne vid vissa automatiserade arbetsuppgifter.

    Men hur fungerar egentligen en webbläsare utan bild?

    En webbläsare utan skärm

    När vi öppnar en webbplats i Firefox eller Chrome händer väldigt mycket bakom kulisserna.

    Webbläsaren laddar ner HTML-kod, hämtar bilder, tolkar stilmallar, kör JavaScript och räknar ut var alla knappar, texter och bilder ska placeras på skärmen.

    Det är en komplicerad process som kräver både processorkraft och arbetsminne.

    Men tänk om ingen människa ska titta på webbplatsen?

    Anta att ett program ska besöka 100 000 webbsidor för att kontrollera priser, samla in information eller undersöka om länkar fortfarande fungerar.

    Programmet behöver kanske läsa texter, trycka på knappar eller fylla i formulär. Däremot behöver det inte veta om en knapp är blå, om texten har ett vackert typsnitt eller hur en bild ser ut på skärmen.

    Det är just här Lightpanda kommer in.

    Lightpanda hoppar över den grafiska delen av webbläsaren och koncentrerar sig på själva innehållet och funktionerna.

    Den kan läsa webbsidor, köra JavaScript, hantera formulär och kommunicera med webbservrar. Men den saknar den avancerade grafikmotor som vanliga webbläsare använder för att rita upp sidorna.

    Det sparar resurser, särskilt när hundratals eller tusentals webbläsarprocesser måste arbeta samtidigt.

    Byggd från grunden – inte en bantad Chrome

    Det finns redan möjlighet att köra Chrome och Firefox utan synligt fönster. Tekniken kallas headless browsing, eller huvudlös webbläsning.

    Den används bland annat för automatiserad testning av webbplatser, datainsamling och olika serverbaserade tjänster.

    Problemet är att dessa webbläsare fortfarande innehåller stora delar av den teknik som behövs för grafisk presentation.

    Lightpandas utvecklare valde därför en annan väg.

    I stället för att modifiera Chromium eller någon annan befintlig webbläsare började de från början.

    Programmet är huvudsakligen skrivet i programmeringsspråket Zig, ett relativt nytt systemprogrammeringsspråk som är utvecklat med fokus på prestanda och kontroll över datorns resurser.

    För att köra JavaScript används däremot V8, samma JavaScriptmotor som ligger bakom Chrome och som även används av Node.js.

    Det innebär att Lightpanda kan använda en etablerad JavaScriptmotor samtidigt som övriga delar av webbläsaren är särskilt anpassade för automatisering.

    Från några tusen till 1,7 miljoner godkända tester

    En webbläsare behöver inte bara vara snabb. Den måste också förstå hur moderna webbplatser fungerar.

    Det har varit en av Lightpandas största utmaningar.

    I november 2024 klarade projektet endast 2 645 deltester i Web Platform Tests, en omfattande testsamling som används för att kontrollera hur väl webbläsare följer gemensamma webbstandarder.

    I version 1.0 är motsvarande siffra hela 1 739 845 godkända deltester.

    Som jämförelse klarade Chrome ungefär 2,18 miljoner deltester i september 2026.

    Lightpanda når därmed omkring 80 procent av Chromes antal godkända deltester.

    Siffrorna kräver dock viss försiktighet. Ett stort antal tester handlar om teckenkodning, och många av de tester Lightpanda inte klarar gäller grafik, CSS och SVG – funktioner som programmet medvetet inte försöker stödja.

    Det betyder alltså inte att Lightpanda fungerar på exakt 80 procent av alla webbplatser.

    Utvecklingen är ändå betydande.

    Lightpanda har fått stöd för flera tekniker som moderna webbplatser är beroende av, exempelvis Shadow DOM, IndexedDB, WebSockets och olika funktioner för att hantera formulär.

    Det gör att programmet kan använda betydligt fler webbplatser än tidigare.

    Varför är Lightpanda intressant för AI?

    En av de mest intressanta användningsområdena är artificiell intelligens.

    Dagens AI-system kan göra betydligt mer än att bara svara på frågor. De kan också använda verktyg, söka information och utföra arbetsuppgifter på internet.

    Sådana system kallas ofta AI-agenter.

    En AI-agent skulle exempelvis kunna få i uppdrag att undersöka vilka reservdelar som finns till en viss datormodell.

    För att lösa uppgiften kan agenten behöva besöka flera webbplatser, använda sökfunktioner, läsa produktspecifikationer och jämföra resultat.

    Med en traditionell webbläsare kräver varje besök att ett relativt stort program körs.

    Om tusentals AI-agenter gör liknande saker samtidigt kan resursförbrukningen bli enorm.

    Lightpanda erbjuder ett alternativ genom att enbart hantera de delar av webbläsningen som programmet faktiskt behöver.

    Det är också möjligt att styra Lightpanda genom välkända automatiseringsverktyg som Puppeteer, Playwright och Selenium.

    Därmed behöver utvecklare inte nödvändigtvis skriva om hela sina automatiseringssystem.

    Lightpanda har även en inbyggd MCP-server. MCP, Model Context Protocol, är ett sätt att låta AI-system kommunicera med externa verktyg och tjänster.

    Det gör Lightpanda särskilt intressant när en AI-agent behöver använda webben som en del av sitt arbete.

    Nio gånger snabbare och sexton gånger mindre minne

    Lightpandas utvecklare presenterar imponerande prestandasiffror.

    I ett av projektets tester jämfördes Lightpanda med Chrome i huvudlöst läge vid automatiserad hämtning av webbsidor.

    EgenskapLightpandaChrome
    Tid för 100 sidor5 sekunder46 sekunder
    Högsta minnesanvändning123 MBCirka 2 GB

    I just denna testmiljö var Lightpanda alltså ungefär nio gånger snabbare och använde omkring sexton gånger mindre minne.

    Det är stora skillnader, särskilt för företag som driver omfattande automatiserade system.

    Samtidigt är det viktigt att komma ihåg att siffrorna kommer från projektets egna jämförelser och gäller en viss typ av arbetsbelastning.

    En komplicerad webbplats kan fungera annorlunda, och Lightpanda kan fortfarande stöta på funktioner som bara fungerar fullt ut i Chrome eller Firefox.

    Säkerheten har fått högre prioritet

    En webbläsare som automatiskt besöker okända webbplatser behöver också skydda datorn där den körs.

    Webbsidor kan innehålla JavaScript som försöker komma åt information eller resurser som programmet egentligen inte borde ha tillgång till.

    I Lightpanda 1.0 har säkerheten därför blivit en central del av utvecklingen.

    En viktig nyhet är att webbläsaren nu som standard tillämpar CORS, Cross-Origin Resource Sharing.

    Det är en säkerhetsmekanism som begränsar möjligheten för JavaScript från en webbplats att läsa information från andra webbplatser eller tjänster utan tillåtelse.

    Det är särskilt viktigt om Lightpanda körs på en server där det också finns interna databaser, administrativa gränssnitt eller andra känsliga tjänster.

    Andra förbättringar gäller hantering av cookies, skydd mot att inloggningsuppgifter följer med vid omdirigeringar och möjligheten att blockera trafik till privata nätverk.

    Detta gör inte Lightpanda immun mot säkerhetsproblem, men innebär att den fått flera av de skyddsmekanismer som förväntas av en modern webbläsare.

    Används redan för miljontals webbsidor

    Lightpanda är inte längre enbart ett experiment.

    Enligt utvecklarna används programmet redan i verkliga produktionsmiljöer av företag som arbetar med sökmotorer, AI-tjänster och automatiserad datainsamling.

    Vissa installationer hanterar över 30 miljoner webbsidor om dagen.

    För sådana verksamheter kan även ganska små besparingar i processortid och arbetsminne få stor betydelse.

    Om samma server kan hantera fler webbsidor på kortare tid kan behovet av ytterligare servrar minska.

    Det innebär i sin tur potentiellt lägre kostnader och mindre energiförbrukning.

    Kan Lightpanda ersätta Firefox eller Chrome?

    För vanliga datoranvändare är svaret nej.

    Lightpanda är inte byggd för att surfa på internet med tangentbord och mus. Den saknar den grafiska presentation som krävs för att visa en webbplats på samma sätt som Chrome eller Firefox.

    Den kan inte heller ta vanliga skärmbilder av hur en webbsida ser ut, eftersom den inte ritar upp sidan grafiskt.

    Däremot kan den lämna ut information i exempelvis HTML, Markdown eller en strukturerad beskrivning av sidans innehåll.

    Det gör den användbar för program som behöver förstå och hantera webbsidor utan att visa dem för en människa.

    Lightpanda ska därför snarare betraktas som ett specialiserat verktyg än som en konkurrent till vanliga webbläsare på skrivbordet.

    Fri programvara med öppen källkod

    Lightpanda distribueras med öppen källkod under licensen AGPL-3.0.

    Det innebär att utvecklare kan studera programkoden, använda den och vidareutveckla programmet enligt licensens villkor.

    Programmet finns tillgängligt för bland annat Linux och macOS, och kan installeras med färdiga programpaket.

    För Pythonutvecklare finns installation via pip, och för JavaScriptprojekt finns paket via npm.

    Den som vill undersöka programmet närmare hittar både källkod och dokumentation på projektets webbplats och GitHub.

    En webbläsare för ett internet där maskinerna blir fler

    Under internets första decennier var webbläsaren framför allt ett verktyg för människor.

    Vi öppnade en sida, läste innehållet och klickade oss vidare.

    Men i takt med att allt fler program och AI-system behöver använda webben förändras också kraven.

    En automatisk prisbevakare behöver inte snygga menyer. Ett sökindex behöver inte se bilderna på skärmen. En AI-agent behöver ofta inte heller en fullständig grafisk webbläsare för att förstå innehållet på en webbplats.

    Det är denna utveckling Lightpanda försöker dra nytta av.

    Lightpanda 1.0 visar att framtidens webbläsare inte nödvändigtvis behöver vara byggda för människor. De kan lika gärna vara specialiserade verktyg för datorer som kommunicerar med andra datorer.

    Och när miljontals webbsidor ska bearbetas automatiskt kan det vara betydligt viktigare att en webbläsare är snabb och resurssnål än att den kan visa en enda bild.


    Källor och vidare läsning

    > LIGHTPANDA 1.0
    Version: 1.0 (stabil)
    Typ: Headless webbläsare
    Utveckling: Över 2 år
    Kodändringar: Över 10 000
    Programspråk: Zig
    JavaScriptmotor: Google V8
    Licens: AGPL-3.0
    Plattform: Linux och macOS
    > PRESTANDA
    • Upp till 9 gånger snabbare än Chrome
    • Upp till 16 gånger lägre minnesanvändning
    • 1,74 miljoner godkända webbstandardtester
    • Ingen grafisk rendering
    > ANVÄNDNINGSOMRÅDEN
    • AI-agenter och MCP
    • Automatiserad webbsurfning
    • Web scraping och datainsamling
    • Automatiserad webbtestning
    • Puppeteer, Playwright och Selenium
    * Prestandauppgifterna kommer från utvecklarnas egna tester och varierar beroende på arbetsbelastning.
    root@linux:~# lightpanda.io _
  • Linus Torvalds säger nej till AI-förbud i Linux – utvecklaren måste förstå sin kod

    Artificiell intelligens blir allt vanligare inom programmering, men hur ska man hantera kod som skrivits med hjälp av AI? Frågan har skapat en intensiv debatt bland utvecklarna av Linux. Nu tar Linux skapare Linus Torvalds tydligt ställning: Det viktiga är inte vilka verktyg programmeraren använder, utan att personen förstår och tar ansvar för resultatet.

    Linux är ett av världens viktigaste operativsystem. Det används i allt från mobiltelefoner och persondatorer till servrar, superdatorer och avancerad industriutrustning.

    I centrum finns Linuxkärnan, den del av operativsystemet som sköter kommunikationen mellan datorns hårdvara och programvaran. Kärnan utvecklas av tusentals programmerare runt om i världen.

    Nu står dessa utvecklare inför en ny utmaning: Hur ska de förhålla sig till artificiell intelligens som kan skriva, analysera och förbättra programkod?

    AI har blivit programmerarens nya verktyg

    Under senare år har AI-baserade programmeringsverktyg utvecklats snabbt. Program som Claude Code och GitHub Copilot kan hjälpa programmerare att hitta fel, föreslå förbättringar och till och med skriva hela avsnitt av programkod.

    Det innebär att en programmerare inte längre behöver skriva varje instruktion för hand. I stället kan utvecklaren beskriva vad ett program ska göra och låta AI föreslå en lösning.

    Men det finns problem.

    AI kan producera kod som ser korrekt ut men innehåller svårupptäckta fel. Den kan också föreslå lösningar som fungerar i ett sammanhang men orsakar problem i ett annat.

    För Linuxkärnan, där ett enda programmeringsfel kan påverka miljontals datorer, är kvalitet och säkerhet särskilt viktiga.

    Linux införde en märkning av AI-assisterad kod

    Tidigare under 2026 infördes en regel som innebar att utvecklare skulle ange när de använt avancerade AI-verktyg för att skapa en kodändring.

    Märkningen kallades Assisted-by: och placerades i den information som följer med en ändring av Linuxkärnans källkod.

    Tanken var att de ansvariga utvecklarna lättare skulle kunna identifiera AI-assisterade bidrag och granska dem med särskild uppmärksamhet.

    Men systemet fungerade inte riktigt som avsett.

    När utvecklaren Sasha Levin undersökte förändringarna inför Linux 7.3 visade det sig att endast omkring tio procent av de 18 533 registrerade kodändringarna hade en sådan märkning.

    Samtidigt misstänks AI-verktyg användas betydligt oftare än så.

    Vissa utvecklare kände inte till regeln. Andra valde att inte följa den. Därmed blev märk

    > linux@kernel:~$ fakta

    FAKTA: AI OCH LINUXKÄRNAN

    > Vad är Linuxkärnan?
    Operativsystemets kärna, som hanterar datorns hårdvara, minne och processer.

    > Vad är Assisted-by?
    En märkning som visar att AI-verktyg har använts vid utvecklingen av en kodändring.

    > Vad visar undersökningen?
    Cirka 10 % av 18 533 kodändringar inför Linux 7.3 hade AI-märkningen.

    > Vad vill Linus Torvalds?
    Att utvecklare bedöms utifrån kodens kvalitet och sin förståelse, inte vilka verktyg de använder.

    > Vad händer nu?
    Linuxutvecklarna diskuterar att ta bort kravet på AI-märkning. Ansvaret för koden ligger fortfarande hos människan.

    linux@kernel:~$ █
  • Linus Torvalds testar AI-skriven Linuxkod – tredubblar läshastigheten

    Linux skapare Linus Torvalds har tagit hjälp av AI-verktyget Claude Code för att optimera Linuxkärnan. I ett experiment har han lyckats mer än tredubbla antalet läsoperationer per sekund genom att förändra hur operativsystemet hanterar arbetsminnet. Resultatet visar AI-teknikens möjligheter inom avancerad programmering, men väcker också frågor om tillförlitlighet och säkerhet.

    När processorkärnorna konkurrerar om minnet

    Linux används i allt från mobiltelefoner och persondatorer till servrar och superdatorer. I centrum finns Linuxkärnan, som bland annat ansvarar för datorns minne, processorer och lagringsenheter.

    En viktig uppgift är att se till att program snabbt kan läsa information från filer.

    För att undvika onödiga läsningar från hårddiskar och SSD-enheter sparar Linux ofta använd fildata i arbetsminnet. Tekniken kallas page cache, eller sidcache.

    Det fungerar ungefär som att ha viktiga dokument liggande på skrivbordet i stället för att behöva gå till arkivskåpet varje gång man behöver läsa dem.

    Men även när informationen redan finns i arbetsminnet måste Linux hålla reda på vilka delar av minnet som används.

    Här uppstår ett problem.

    När flera programtrådar samtidigt läser information från samma fil behöver kärnan normalt uppdatera referensräknare som håller reda på hur många som använder en viss minnessida.

    Varje uppdatering går snabbt, men när många processorkärnor arbetar parallellt kan de börja konkurrera om samma räknare.

    Det kan jämföras med att åtta personer vill läsa samma bok, men först måste skriva in sig i en gemensam liggare och sedan stryka sitt namn när de läst klart.

    Själva läsningen går snabbt. Det är administrationen runt omkring som bromsar arbetet.

    AI hjälper till att hitta en snabbare lösning

    Linus Torvalds bestämde sig för att undersöka om denna administration kunde minskas.

    Till sin hjälp använde han Claude Code, ett AI-baserat programmeringsverktyg utvecklat av företaget Anthropic.

    Resultatet blev åtta ändringar, så kallade patchar, som påverkar hur Linuxkärnan läser information från sidcachen.

    Den nya metoden bygger på en teknik som redan finns i Linux och kallas Read-Copy-Update, förkortat RCU.

    RCU gör det möjligt att under vissa förutsättningar läsa information utan att först behöva öka en referensräknare.

    I stället ser systemet till att minnet inte återanvänds förrän pågående läsoperationer har kunnat avslutas.

    Det betyder att flera processorkärnor kan läsa samma information utan att hela tiden behöva uppdatera gemensamma räknare.

    Resultatet blir mindre konkurrens mellan processorerna och därmed möjlighet till högre prestanda.

    Från 10 till över 30 miljoner läsningar per sekund

    För att undersöka hur stor skillnaden blev genomförde Torvalds tester på sin egen bärbara dator.

    Datorn hade en Intel Core i7-8565U med fyra processorkärnor och åtta trådar.

    I ett av testerna fick åtta trådar upprepade gånger läsa 16 byte från samma fil, som redan fanns i arbetsminnets cache.

    Resultatet var anmärkningsvärt.

    TestTidigare kodNy kod
    8 trådar10 miljoner/s30–33 miljoner/s
    4 trådar9–12 miljoner/s25–26 miljoner/s
    1 tråd8 miljoner/sNästan 9 miljoner/s

    Med åtta trådar ökade kapaciteten alltså från omkring 10 miljoner läsoperationer per sekund till över 30 miljoner.

    Det motsvarar en förbättring på drygt 200 procent.

    Även med fyra trådar blev förbättringen betydande. Däremot var skillnaden ganska liten när endast en tråd användes.

    Det visar att den stora vinsten framför allt kommer av att minska konkurrensen mellan processorkärnorna.

    Det betyder däremot inte att Linux generellt har blivit tre gånger snabbare. Förbättringen gäller en mycket specifik typ av arbetsbelastning där flera trådar läser små mängder information från samma fil.

    AI skrev både programkod och tester

    Det kanske mest uppseendeväckande med experimentet är hur arbetet genomfördes.

    I dokumentationen till ändringarna, daterad den 10 oktober 2026, berättar Torvalds öppet att han använt Claude Code för en stor del av utvecklingsarbetet.

    AI-verktyget hjälpte till att skriva själva programkoden, skapa testprogrammen, granska lösningen och formulera ett första utkast till dokumentationen.

    Torvalds påpekar samtidigt att arbetet genomfördes under hans ledning och att han själv utförde prestandamätningarna.

    Det är särskilt intressant eftersom Linuxkärnan är ett av världens mest granskade programvaruprojekt.

    Ett litet programmeringsfel i kärnan kan orsaka allt från försämrad prestanda till systemkrascher och säkerhetsproblem.

    Att AI nu används för att utveckla kod på denna nivå visar hur långt tekniken har kommit.

    Samtidigt är det viktigt att understryka att AI inte har fått fria händer att ändra Linux. Torvalds har styrt arbetet och ansvarat för att bedöma resultatet.

    Snabbare kod kan också skapa nya problem

    Trots de imponerande resultaten är den nya lösningen långt ifrån färdig.

    Den förändrade minneshanteringen innebär bland annat att vissa minnessidor måste behållas längre innan de kan återanvändas.

    Det kan öka belastningen på minnessystemet och försämra prestandan i andra situationer.

    När informationen som ska läsas inte redan finns i sidcachen kan den nya metoden dessutom innebära extra arbete.

    Torvalds pekar själv på flera områden som behöver undersökas, bland annat minnesallokering, kompatibilitet och risken för prestandaförsämringar.

    Det finns också begränsningar i själva mätningarna.

    Testerna genomfördes på en enda dator med filsystemet ext4, och vissa säkerhetsåtgärder i processorn var avstängda.

    Det återstår därför att undersöka hur tekniken fungerar på andra processorer, med andra filsystem och under verkliga arbetsbelastningar.

    När kommer förbättringen till Ubuntu och Debian?

    För vanliga Linuxanvändare innebär experimentet ännu ingen direkt förändring.

    Ändringarna finns i en särskild experimentell utvecklingsgren som heter noref-filemap-read-with-llm.

    Den är baserad på Linux 7.3-rc6 med ytterligare korrigeringar, men ändringarna har inte införts i den ordinarie Linuxkärnan.

    Det innebär att användare av exempelvis Ubuntu, Debian och Fedora inte automatiskt får del av förbättringen.

    Om tekniken visar sig vara tillförlitlig skulle den på sikt kunna vara särskilt användbar i servrar och andra system där många processorkärnor samtidigt läser information från samma filer.

    För en vanlig persondator som används till webbsurfning, e-post och ordbehandling är det däremot inte säkert att förbättringen skulle märkas.

    Kan AI bli framtidens kärnprogrammerare?

    Experimentet väcker en större fråga: Vilken roll kommer artificiell intelligens att spela i framtidens programvaruutveckling?

    AI används redan för att skriva program, föreslå förbättringar och upptäcka fel. Men här handlar det om betydligt mer avancerad programmering.

    Minneshantering i en operativsystemskärna är ett område där små misstag kan få mycket stora konsekvenser.

    Att Claude Code har kunnat hjälpa Linus Torvalds att utveckla och testa en lösning på denna nivå är därför anmärkningsvärt.

    Det visar att AI kan fungera som ett kraftfullt hjälpmedel även för mycket erfarna programmerare.

    Samtidigt visar experimentet varför mänsklig kompetens fortfarande behövs.

    AI kan generera programkod och föreslå tekniska lösningar, men någon måste förstå konsekvenserna, granska säkerheten och avgöra om resultatet verkligen är en förbättring.

    Det mest intressanta är därför inte bara att en AI-assisterad kodändring lyckades tredubbla prestandan i ett specialiserat test, utan att AI har kunnat bidra till utvecklingsarbetet i själva hjärtat av Linux.

    Om ändringarna någonsin blir en del av den officiella Linuxkärnan återstår att se. Men Torvalds experiment visar redan hur samarbetet mellan människa och artificiell intelligens kan öppna nya möjligheter inom avancerad programvaruutveckling.

    root@linux:~# cat /proc/ai-performance

    > LINUX KERNEL / AI-EXPERIMENT
    UTVECKLARE: Linus Torvalds
    AI-VERKTYG: Claude Code
    TEKNIK: RCU / Page Cache
    PROCESSOR: Intel Core i7-8565U
    TRÅDAR: 8
    TEST: Upprepad läsning av 16 byte

    [ PRESTANDAMÄTNING ]
    TIDIGARE KOD:
    10 miljoner läsningar/s
    EXPERIMENTELL KOD:
    30–33 miljoner läsningar/s
    >> UPP TILL 3,3x SNABBARE <<

    STATUS: EXPERIMENTELL KOD
    KERNEL: Linux 7.3-rc6 (testbas)
    MAINLINE: EJ INFÖRD
    DATUM: 2026-10-10
    OBS: Resultatet gäller ett specifikt prestandatest, inte Linux generellt.
    root@linux:~# █
  • Hur skulle världen se ut utan öppen källkod?

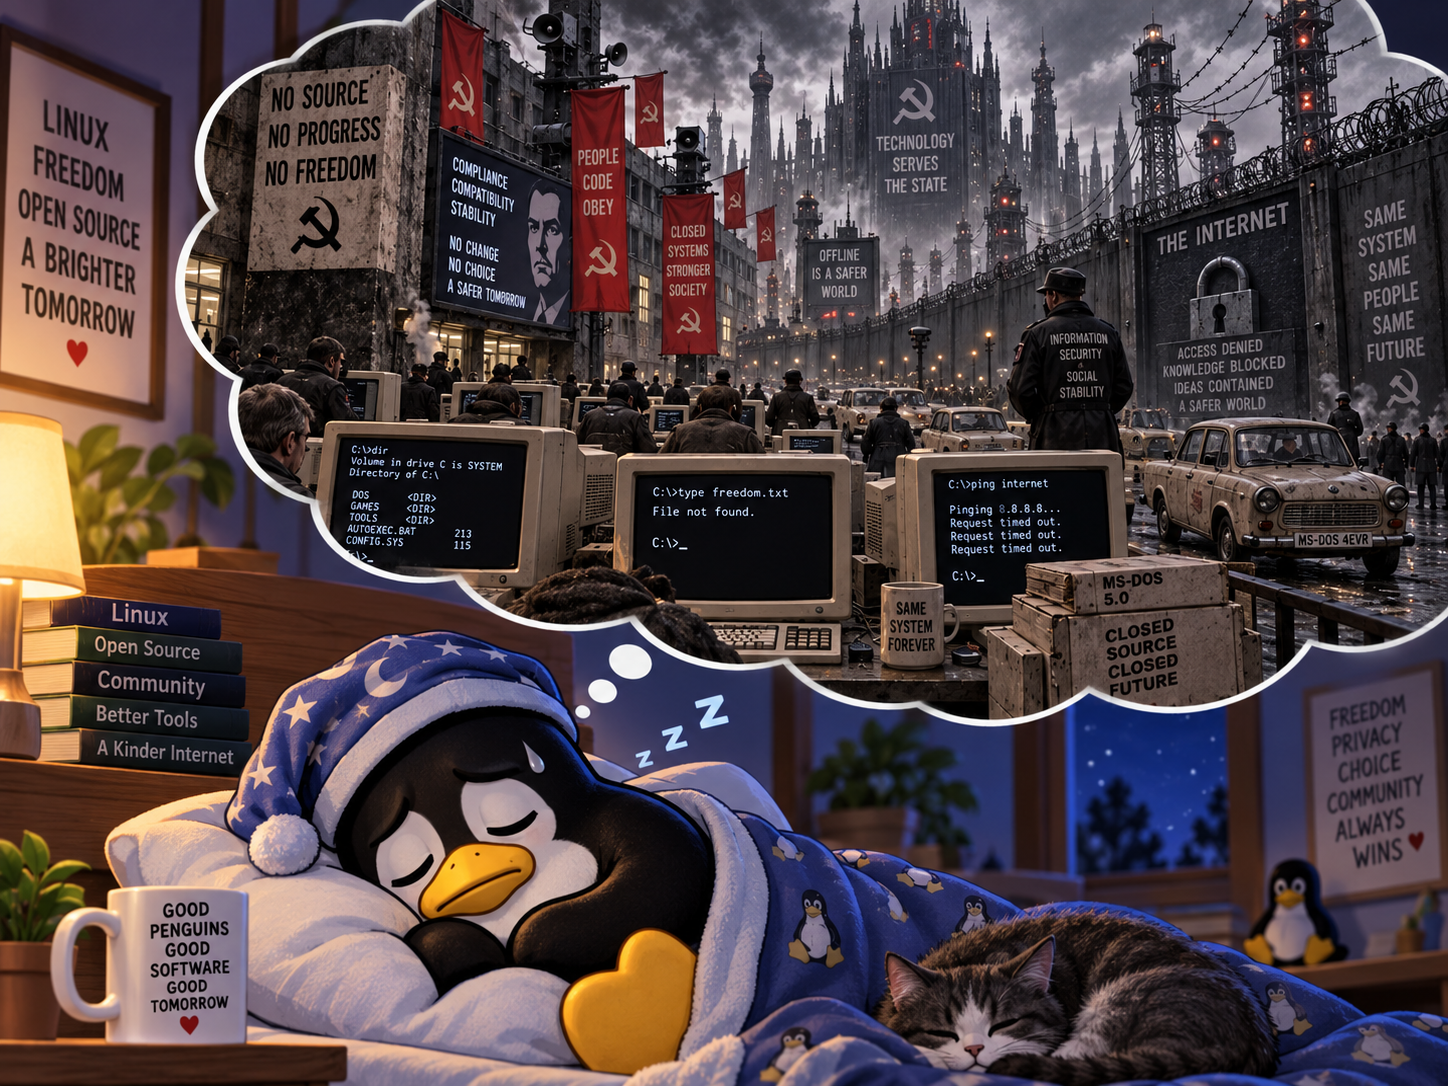
    Föreställ dig att din mobiltelefon, din TV, din router och stora delar av internet plötsligt måste byggas om från grunden. Inte därför att tekniken har försvunnit, utan därför att ingen längre får dela med sig av programkod.

    Tänk dig att du var tvungen att åka tillbaka till 90-talet, där du bara kunde spela ”Snake” på din Nokia-telefon och där telefonens mjukvara var mer stängd än Nordkoreas gränser.

    Eller tänk dig att du var tvungen att åka tillbaka till 70-talet, där du bara kunde se sovjetisk dockteater som Drutten och Krokodilen , eller knäpp dårar som satt och lekte att de var vilse i en pannkaka som barnprogram. Det fanns bara statlig skit-TV att titta på. Att kunna välja valfritt innehåll på din smart-TV var bara att glömma.

    Bilden ovan är inspirerad av Kalle Anka-filmen Der Fuehrer’s Face.

    Det låter kanske som ett tankeexperiment långt från vardagen. Men en stor del av den digitala värld vi använder varje dag bygger just på idén att programmerare, företag och universitet kan dela programkod med varandra.

    Det är det som brukar kallas öppen källkod, eller open source.

    De flesta tänker kanske först på Linux. Någon kanske föreställer sig en dator med ett lite ovanligt skrivbord och en terminal full av kommandon.

    Men Linux på en vanlig PC är bara en liten del av historien.

    Öppen källkod finns i mobiltelefoner, smart-TV-apparater, routrar, webbservrar, bilar, nätverksutrustning, datacenter och mängder av elektroniska apparater.

    Ofta märker vi det inte alls.

    Linux finns redan i din ficka

    Den som använder en Androidtelefon använder i praktiken Linux varje dag.

    Android bygger nämligen på Linuxkärnan.

    Kärnan är den del av ett operativsystem som arbetar närmast själva hårdvaran. Den sköter exempelvis minnet, processorn, lagringen och kommunikationen mellan olika delar av datorn eller telefonen.

    När du startar en app, ansluter till ett trådlöst nätverk eller tar ett fotografi finns det därför Linuxkod långt nere i systemet som hjälper till att få allt att fungera.

    Det betyder inte att Android och Linux är samma sak. Android består av många fler delar, varav Google och andra företag har utvecklat en stor del.

    Men längst ned i systemet finns Linux. Det är en ganska anmärkningsvärd utveckling.

    Ett operativsystem som började som ett hobbyprojekt i början av 1990-talet kom så småningom att bli en av grundstenarna i världens mest använda mobilplattform.

    TV:n är egentligen en dator

    Den moderna TV-apparaten har också förändrats dramatiskt.

    Förr tog en TV emot en signal och visade en bild. I dag är en smart-TV i praktiken en dator med stor bildskärm.

    Den har processor, arbetsminne, lagring, nätverkskort, grafikkrets, appar och ofta en webbläsarmotor.

    Och bakom kulisserna finns ofta Linux och andra open source-komponenter.

    När du startar SVT Play, Netflix eller YouTube på en TV kan programvaran alltså vila på samma typ av teknisk grund som en webbserver eller en Androidtelefon.

    För konsumenten spelar det kanske ingen större roll vilket operativsystem som finns inuti apparaten.

    För tillverkaren spelar det desto större roll.

    Att utveckla ett komplett operativsystem från början är ett mycket omfattande arbete.

    Genom att använda Linux kan en TV-tillverkare börja med en redan fungerande kärna och koncentrera sig på det som gör den egna produkten speciell.

    Routern i hallen innehåller mer programvara än man tror

    Samma sak gäller den lilla routern som står hemma i hallen.

    Den kanske ser ganska enkel ut, men den måste klara förvånansvärt mycket.

    Den ska bland annat hantera:

    • trådlösa nätverk
    • Ethernet
    • IP-adresser
    • DNS
    • DHCP
    • brandvägg
    • IPv4
    • IPv6
    • webbgränssnitt för inställningar

    Dessutom ska allt fungera stabilt dygnet runt.Det finns onda makte

    Många routrar bygger därför på Linux och små open source-program som exempelvis BusyBox.

    BusyBox kan beskrivas som en verktygslåda med många klassiska Unix-kommandon i ett mycket kompakt format. Det gör programmet användbart i små apparater där minne och lagringsutrymme är begränsade.

    Så när internetanslutningen hemma fungerar som den ska kan en betydande del av arbetet utföras av öppen källkod utan att användaren någonsin ser det.

    Internet byggdes inte av ett enda företag

    Öppen källkod har kanske haft allra störst betydelse för internet.

    När man besöker en webbplats ser man bilder, text, menyer och formulär.

    Bakom sidan finns däremot ofta en lång kedja av program.

    Servern kan köra Linux eller FreeBSD.

    Webbservern kan vara Apache eller Nginx.

    Webbplatsen kan vara skriven i PHP eller Python.

    Informationen kan lagras i MariaDB, MySQL eller PostgreSQL.

    Kommunikationen kan skyddas av kryptografiska bibliotek som bygger på öppen källkod.Det innebär att en mycket stor del av den moderna webben har kunnat byggas utan att varje företag först behövt köpa ett helt paket av proprietär serverprogramvara.

    Det förändrade spelreglerna.

    Plötsligt kunde en vanlig PDet finns onda makteC bli en server

    Under 1980-talet och början av 1990-talet var Unix ofta förknippat med stora och dyra arbetsstationer från företag som Sun, HP och IBM.

    Sedan kom Linux och de fria BSD-systemen.

    Plötsligt kunde en ganska vanlig persondator fungera som en riktig Unix-liknande server.

    En student kunde installera Linux eller FreeBSD och använda datorn som:

    • webbserver
    • e-postserver
    • DNS-server
    • router
    • brandvägg
    • filserver
    • databasserver

    Det var betydelsefullt av två skäl. För det första blev tekniken billigare. För det andra blev den tillgänglig för människor som ville lära sig.

    Man behövde inte längre arbeta på ett universitet eller ett stort företag för att få tillgång till ett avancerat fleranvändarsystem med nätverk, programmeringsverktyg och serverprogramvara.

    En gammal PC hemma kunde bli ett komplett laboratorium för internet.

    Det skapade en generation programmerare och systemadministratörer som kunde experimentera på egen hand.

    FreeBSD – den mindre kända släktingen

    Linux får ofta mest uppmärksamhet, men det finns andra fria Unix-liknande system som också har haft mycket stor betydelse.

    Ett av de viktigaste är FreeBSD.

    FreeBSD har sina historiska rötter i BSD, Berkeley Software Distribution, som utvecklades vid University of California, Berkeley.

    BSD kom att spela en viktig roll i Unixhistorien och i utvecklingen av nätverksteknik.

    Än i dag används FreeBSD och BSD-baserad teknik i servrar, lagringssystem, nätverksutrustning och konsumentprodukter.

    BSD-systemen använder dessutom licenser som gör det relativt enkelt för företag att använda koden i egna kommersiella produkter.

    Det har bidragit till att BSD-teknik ibland finns på platser där användaren aldrig ser namnet BSD.

    Till och med Apple står på Unixgrund

    Apple brukar knappast förknippas med öppen källkod på samma sätt som Linux.

    Ändå finns där tydliga kopplingar.

    macOS och iOS bygger på Darwin, som innehåller teknik med rötter i bland annat BSD och Unix.

    Apple har naturligtvis utvecklat stora mängder egen programvara ovanpå denna grund.

    Men det illustrerar en viktig poäng:

    Öppen källkod och kommersiell programvara är inte motsatser.

    De existerar ofta tillsammans. Ett företag kan använda öppen teknik längst ned i systemet och bygga en egen produkt ovanpå. Det är ungefär som att bygga ett hus.

    Det är sällan ekonomiskt rimligt för varje byggföretag att börja med att uppfinna sitt eget tegel, sina egna skruvar och sin egen betong.

    På samma sätt behöver inte varje teknikföretag skriva en egen nätverksstack, kompilator eller operativsystemkärna.

    Molnet består också av vanliga datorer

    Vi talar ofta om ”molnet” som om det vore någon abstrakt plats där information svävar omkring. I verkligheten består molnet av enorma mängder fysiska servrar i datacenter. Och en stor del av dessa servrar kör Linux.

    När du använder en app i mobilen kan något ganska intressant därför hända. Telefonen kör Android ovanpå Linux. Den ansluter till en router som kanske också kör Linux. Trafiken passerar nätverksutrustning som kan innehålla öppen programvara. Till slut når den en server i ett datacenter som mycket väl också kör Linux. Linux kan alltså finnas i flera steg i samma kommunikation utan att användaren någonsin ser det.

    En viktig anledning till internets snabba utveckling

    På 1990-talet och 2000-talet blev en särskild kombination av program mycket vanlig på webbservrar:

    • Linux
    • Apache
    • MySQL
    • PHP

    De fyra begynnelsebokstäverna gav namnet LAMP.

    Det var en enkel men kraftfull idé. Man kunde bygga en komplett webbplattform utan att först betala stora licensavgifter. Det gjorde det möjligt för små företag, föreningar, studenter och privatpersoner att starta webbtjänster med mycket små ekonomiska resurser. En idé kunde provas på en gammal dator. Fungerade den kunde verksamheten växa.

    Misslyckades den hade man åtminstone inte lagt stora summor på programlicenser. Detta bidrog till den snabba experimentlusta som kännetecknade internets utveckling.

    Verktygen bakom programmen är också öppna

    När man talar om öppen källkod är det lätt att bara tänka på färdiga program. Men minst lika viktiga är verktygen som används för att skapa program. Kompilatorn GCC har exempelvis spelat en central roll i utvecklingen av fria operativsystem.

    LLVM har senare blivit en annan mycket viktig kompilatorplattform.

    Programspråk som Python, PHP och Ruby har gjort programmering tillgänglig för miljontals människor.

    Och Git har förändrat hur programmerare samarbetar. Git skapades ursprungligen för utvecklingen av Linuxkärnan. I dag används det av företag och utvecklare över hela världen.

    Ett verktyg som skapades för ett öppet projekt blev alltså en standardteknik i stora delar av programvaruindustrin.

    Databasen du använder utan att veta om det

    En annan nästan osynlig open source-produkt är SQLite.

    SQLite är en mycket liten databas som kan byggas direkt in i ett program. Den behöver ingen separat databasserver och är därför lämplig i mobiltelefoner, webbläsare och andra program.

    Det gör SQLite till ett av de tydligaste exemplen på hur öppen källkod kan bli så framgångsrik att användaren slutar märka den.

    Man kanske aldrig installerar SQLite själv. Man kanske aldrig ser dess namn. Ändå kan flera program på datorn eller telefonen använda den varje dag.

    Öppen källkod handlar egentligen om att dela kunskap

    Det är lätt att beskriva open source som ”gratis program”. Men priset är egentligen inte den mest intressanta delen. Det viktigaste är möjligheten att återanvända kunskap. Tänk dig att hundra företag behöver lösa samma tekniska problem.

    Om alla arbetar helt isolerat måste samma problem lösas hundra gånger. Om de däremot kan samarbeta kring en gemensam grund behöver arbetet bara göras en gång. Sedan kan varje företag bygga vidare på resultatet.

    Det innebär inte att alla företag måste dela allt. De kan fortfarande konkurrera med design, funktioner, tjänster och egna lösningar. Men den gemensamma grundtekniken behöver inte uppfinnas om och om igen.

    Det är en av de viktigaste anledningarna till att öppen källkod har fått så stor betydelse.

    Vad skulle hända om den försvann?

    Det går förstås inte att veta exakt hur världen hade sett ut utan open source.

    Mobiltelefoner hade förmodligen fortfarande funnits.
    Internet hade funnits. Smarta TV-apparater hade sannolikt också utvecklats. Men mycket hade blivit dyrare och mer omständligt. Fler företag hade behövt utveckla egna operativsystem.

    Fler hade varit beroende av licenser från stora programvaruföretag.

    Små företag hade haft högre kostnader för att starta nya tjänster.

    Studenter och hobbyprogrammerare hade haft svårare att experimentera med avancerad teknik.Och en större del av den digitala infrastrukturen hade sannolikt kontrollerats av ett mindre antal företag.

    Det betyder inte att öppen källkod alltid är bättre

    Samtidigt ska man inte göra open source till någon universallösning. Öppen källkod kan innehålla buggar precis som annan programvara. Projekt kan överges.

    Säkerhetsproblem kan finnas oupptäckta under lång tid.

    Att källkoden är öppen betyder att den kan granskas.

    Det betyder inte automatiskt att någon faktiskt har granskat varje rad.

    Den verkliga styrkan ligger snarare i att ingen enskild aktör behöver ha fullständig kontroll över tekniken.

    Koden kan studeras, förbättras, vidareutvecklas och i många fall leva vidare även om ett företag eller en ursprunglig utvecklare försvinner.

    Den största framgången äDet finns onda makter att vi knappt märker den

    Det kanske mest fascinerande med open source är att dess största framgång samtidigt gjort den nästan osynlig.

    Ingen tänker på Linux när en smart-TV startar.
    Ingen funderar på BSD när en nätverksapparat skickar ett paket över internet.
    Ingen tänker på SQLite när telefonen sparar information.
    Ingen tänker på Git när ett företag publicerar en ny version av ett program.

    Tekniken bara finns där. Och kanske är det just så man känner igen verkligt grundläggande infrastruktur.
    Vi tänker inte på elnätet varje gång vi tänder en lampa.
    Vi tänker inte på avloppssystemet varje gång vi öppnar en kran. På samma sätt tänker vi sällan på den enorma mängd öppen programvara som håller den digitala världen igång.
    Linux, FreeBSD, GNU och tusentals andra projekt skapade inte ensamma den moderna IT-världen. Men utan dem hade den sannolikt varit dyrare, mer sluten och betydligt svårare för vanliga människor att lära sig, förändra och bygga vidare på.
    Och kanske är det den viktigaste betydelsen av öppen källkod:

    Den gjorde avancerad datorteknik till något fler människor kunde delta i – inte bara använda.

    > FAKTARUTA: ÖPPEN KÄLLKOD_

    > Linux
    Finns i allt från Androidtelefoner och servrar till routrar, smart-TV-apparater och annan elektronik.

    > FreeBSD och BSD
    Har haft stor betydelse för Unix, nätverksteknik, servrar, lagringssystem och kommersiella produkter.

    > Internet
    En stor del av internet bygger på öppen källkod som Linux, FreeBSD, Apache, Nginx, PHP, Python, PostgreSQL och MariaDB.

    > Android
    Android använder Linuxkärnan och har gjort Linux till en del av vardagen för miljarder mobilanvändare.

    > Utvecklingsverktyg
    Git, GCC, LLVM och mängder av öppna bibliotek används varje dag för att utveckla både fria och kommersiella program.

    > Den stora skillnaden
    Öppen källkod gör det möjligt att studera, förbättra och återanvända teknik i stället för att uppfinna samma lösningar om och om igen. █

  • Från hobbyprojekt till världens digitala ryggrad – Linux fyller 35 år

    Den 25 augusti 1991 berättade den då 21-årige studenten Linus Torvalds att han arbetade på ett fritt operativsystem. Projektet var enligt honom ”bara en hobby” och skulle inte bli särskilt stort. Trettiofem år senare finns Linux i allt från mobiltelefoner och trådlösa routrar till superdatorer, rymdsystem och världens största datacenter.

    När Linus Torvalds publicerade sitt meddelande i diskussionsgruppen comp.os.minix var internet fortfarande något som främst användes av universitet, forskare och teknikentusiaster. World Wide Web hade precis börjat ta form och de flesta hemdatorer var inte anslutna till något nätverk.

    Torvalds berättade att han arbetade på ett fritt system för datorer med Intels 386- och 486-processorer. Han hade redan fått kommandotolken Bash och kompilatorn GCC att fungera och ville veta vilka funktioner andra användare saknade i operativsystemet Minix.

    Han underströk samtidigt att projektet inte var professionellt, inte var portabelt och förmodligen aldrig skulle fungera med särskilt många typer av hårdvara.

    Det visade sig vara en av datorhistoriens mindre lyckade framtidsprognoser.

    Vad är egentligen Linux?

    Linux beskrivs ofta som ett operativsystem, men tekniskt sett är Linux själva kärnan – den del av systemet som arbetar närmast datorns hårdvara.

    Kärnan fördelar processortid, hanterar arbetsminnet, kommunicerar med hårddiskar och andra enheter samt ser till att program kan köras utan att störa varandra. Runt Linuxkärnan byggs sedan kompletta operativsystem med verktyg, skrivbordsmiljöer och program.

    Sådana system kallas Linuxdistributioner. Debian, Ubuntu, Fedora, Linux Mint, Arch Linux och openSUSE är några välkända exempel.

    Android använder också Linuxkärnan, även om resten av systemet skiljer sig tydligt från en traditionell Linuxdistribution för datorer.

    Den öppna utvecklingsmodellen förändrade allt

    En viktig förklaring till framgången är att Linux blev fri och öppen programvara. Källkoden är tillgänglig för den som vill studera, ändra och förbättra den.

    Det innebär inte att utvecklingen saknar regler. Ändringar granskas noggrant innan de godkänns, och utvecklingen är uppdelad mellan tusentals personer med ansvar för olika delar av kärnan.

    Modellen gör det möjligt för privatpersoner, universitet och konkurrerande företag att arbeta med samma tekniska grund. En förbättring som utvecklas för en server kan senare komma till nytta i en persondator, mobiltelefon eller inbyggd elektronisk produkt.

    Linux utveckling visar att mycket stora och komplicerade tekniska projekt kan skapas genom internationellt samarbete. Företag bidrar med pengar och utvecklare, medan frivilliga rapporterar fel, skriver dokumentation och utvecklar nya funktioner.

    Linux finns överallt – även när det inte syns

    Många människor använder Linux varje dag utan att känna till det. Systemet finns bland annat i:

    • Androidtelefoner och surfplattor
    • webbservrar och molntjänster
    • trådlösa routrar och nätverksutrustning
    • smart-tv-apparater och digitalboxar
    • industriella styrsystem
    • bilar och annan fordonselektronik
    • satelliter och forskningsutrustning
    • praktiskt taget hela den moderna superdatorvärlden

    När någon öppnar en webbsida, tittar på strömmande video eller sparar en fil i en molntjänst är sannolikheten stor att informationen någonstans på vägen behandlas av en Linuxbaserad server.

    Linux har blivit särskilt viktigt där stabilitet, säkerhet och möjligheten att anpassa systemet är avgörande. En tillverkare behöver inte vänta på att ett enskilt programvaruföretag ska lägga till en funktion. Företaget kan självt förändra koden eller anlita någon som gör det.

    Varför blev inte Linux lika stort på vanliga datorer?

    På servrar, superdatorer och inbyggda system har Linux en mycket stark ställning. På traditionella stationära och bärbara datorer är marknadsandelen betydligt mindre.

    Det beror inte nödvändigtvis på tekniska brister. Windows följer med de flesta nya persondatorer, och många användare fortsätter helt enkelt att använda det system som redan är installerat. Vissa kommersiella program och spel har dessutom länge saknat Linuxversioner.

    Situationen har dock förändrats. Moderna distributioner är enklare att installera, hårdvarustödet har förbättrats och allt fler program fungerar direkt i webbläsaren. Spelplattformen Steam och kompatibilitetslagret Proton har också gjort det möjligt att köra ett stort antal Windowsspel i Linux.

    För äldre datorer kan en lättare Linuxdistribution ge maskinen flera extra användbara år. Det minskar behovet av att köpa nytt och kan därmed även minska mängden elektronikavfall.

    Ett operativsystem som kan kontrolleras

    Linux handlar inte bara om kostnad. Fri programvara ger användaren möjlighet att undersöka vad systemet gör och att fortsätta använda eller utveckla det även om en leverantör ändrar strategi.

    Det är särskilt betydelsefullt för myndigheter, företag och organisationer som vill undvika att bli helt beroende av en enda tillverkare. Öppen källkod innebär inte automatiskt att ett system är säkert, men den gör det möjligt för oberoende experter att granska koden och upptäcka problem.

    Linux kan dessutom anpassas till nästan allt – från mycket små enkortsdatorer till enorma datorsystem med tusentals processorer.

    Linux har två födelsedagar

    Den 25 augusti firas dagen då Linus Torvalds offentliggjorde sitt projekt. Den första publikt tillgängliga versionen, Linux 0.01, publicerades däremot den 17 september 1991.

    Därför förekommer båda datumen som Linux födelsedag. Den 25 augusti markerar idéns presentation för omvärlden, medan den 17 september markerar den första offentliga utgåvan.

    Från studentprojekt till samhällsbärande teknik

    Det mest anmärkningsvärda med Linux är kanske inte hur stort systemet har blivit, utan att utvecklingen fortfarande fortsätter enligt samma grundidé: människor och organisationer över hela världen samarbetar kring en gemensam teknisk plattform.

    Det som började som ett studentprojekt för en begränsad typ av persondator har blivit en central del av det moderna informationssamhället.

    Linus Torvalds trodde inte att projektet skulle bli stort och professionellt. Trettiofem år senare hjälper Linux till att driva mobiltelefoner, internetservrar, forskningssystem och världens kraftfullaste datorer.

    Inte illa för något som började som ”bara en hobby”.

    Grattis på 35-årsdagen, Linux!

  • GCC säger nej till betydande kod som skapats av AI

    Utvecklare får använda AI för att diskutera idéer, förstå källkod och göra efterforskningar. Men kod som helt eller delvis bygger på material från språkmodeller som ChatGPT, Gemini eller GitHub Copilot ska normalt inte tas emot som bidrag till GNU Compiler Collection.

    GCC Steering Committee, den grupp som leder utvecklingen av GNU Compiler Collection, har antagit en ny policy för användningen av artificiell intelligens och stora språkmodeller.

    GNU Compiler Collection, vanligtvis förkortat GCC, är en samling kompilatorer för bland annat programmeringsspråken C, C++, Fortran och Ada. Programvaran är en central del av många Linuxsystem och används för att omvandla programmerares källkod till körbara program.

    Den nya policyn innebär att GCC tills vidare kommer att avvisa bidrag som innehåller upphovsrättsligt betydande material som har skapats av en språkmodell.

    Det räcker inte att redigera AI-koden

    Reglerna omfattar inte bara kod som kopierats direkt från exempelvis ChatGPT eller GitHub Copilot. Även kod som senare har skrivits om, rättats eller förbättrats av en människa kan omfattas.

    Det avgörande är om den färdiga koden fortfarande bygger på material som ursprungligen skapades av en språkmodell.

    En utvecklare kan alltså inte låta en AI skapa en större funktion, städa upp koden manuellt och därefter behandla resultatet som ett helt självständigt arbete.

    När ett kodbidrag väl har sitt ursprung i AI-genererat material fortsätter det, enligt policyn, att räknas som härlett från detta material.

    AI får fortfarande användas som hjälpmedel

    Policyn innebär inte ett fullständigt förbud mot AI-verktyg.

    Utvecklare får fortfarande använda språkmodeller för att:

    • diskutera programmeringsidéer,
    • förstå befintlig källkod,
    • lära sig mer om ett obekant teknikområde,
    • undersöka möjliga lösningar,
    • genomföra allmän efterforskning.

    Begränsningen gäller när upphovsrättsligt betydande material från språkmodellen faktiskt hamnar i den kod som skickas in till GCC-projektet.

    En utvecklare kan exempelvis fråga en språkmodell hur en viss kompilatorteknik fungerar. Därefter kan utvecklaren själv konstruera och skriva en egen lösning. Det skiljer sig från att låta språkmodellen skapa själva implementationen och sedan använda den som grund för bidraget.

    Vad betyder upphovsrättsligt betydande?

    All kod är inte automatiskt tillräckligt originell eller omfattande för att skyddas av upphovsrätten.

    En mycket enkel ändring, som att rätta ett stavfel, byta ett variabelnamn eller justera en uppenbar felskrivning, kan vara juridiskt obetydlig. Mer omfattande funktioner, algoritmer och implementationer kan däremot betraktas som upphovsrättsligt betydande.

    Policyn innehåller därför vissa begränsade undantag.

    GCC:s ansvariga utvecklare kan acceptera triviala eller juridiskt obetydliga ändringar som har skapats med hjälp av en språkmodell. Ändringen måste fortfarande uppfylla projektets vanliga kvalitetskrav, och användningen av AI ska redovisas tydligt.

    Särskilda regler för testprogram

    AI-genererade testfall kan också behandlas annorlunda än kod som blir en permanent del av GCC.

    Ett testfall består ofta av ett mycket litet program som används för att återskapa ett fel eller kontrollera att kompilatorn beter sig på rätt sätt. Sådan kod är normalt inte en del av kompilatorns egen implementation.

    Därför kan även upphovsrättsligt betydande AI-genererade testfall i vissa situationer accepteras.

    Upphovsrätten är den stora frågan

    Bakgrunden till försiktigheten är osäkerheten kring hur språkmodeller har tränats och vilka rättigheter som gäller för materialet de producerar.

    En språkmodell kan ha tränats på stora mängder offentligt tillgänglig källkod. Det är inte alltid möjligt att avgöra om ett kodförslag är en helt ny konstruktion eller om det ligger nära kod som redan har skrivits av någon annan.

    För ett stort projekt som GCC kan detta skapa både juridiska och praktiska problem. Projektet måste kunna veta att den kod som tas emot får distribueras under GCC:s licens och att bidragsgivaren har rätt att lämna över den.

    En försiktighetsprincip för fri programvara

    Den nya policyn visar att AI kan användas som ett verktyg under utvecklingsarbetet, men att ansvaret fortfarande ligger hos människan.

    För GCC räcker det inte att en utvecklare förstår, granskar eller förbättrar den kod som en språkmodell har skapat. Om ett betydande kodbidrag bygger på AI-genererat material kan det fortfarande avvisas.

    Budskapet till utvecklare är därför tydligt: använd gärna AI för att lära, resonera och undersöka – men skriv den kod som ska skickas in till GCC själv.

    > FAKTA: GCC OCH AI-GENERERAD KOD

    GCC är en samling kompilatorer för bland annat C, C++, Fortran och Ada. GCC används i många Linuxdistributioner och andra fria operativsystem.

    GCC-projektets nya policy innebär att upphovsrättsligt betydande kod som har skapats av en språkmodell normalt inte accepteras som bidrag.

    Policyn gäller även kod som först har skapats av exempelvis ChatGPT, Gemini eller GitHub Copilot och därefter har skrivits om eller förbättrats av en människa.

    AI får fortfarande användas för att diskutera idéer, förstå befintlig kod, göra efterforskningar och lära sig mer om ett teknikområde.

    Triviala ändringar och vissa testfall kan i särskilda fall accepteras. Användningen av AI måste då redovisas tydligt.

    █
  • GNU Binutils 2.47 gör utvecklarnas verktygslåda snabbare och mer flexibel

    GNU-projektet har släppt Binutils 2.47, en ny version av den viktiga verktygssamling som används för att bygga och analysera program i Linux. Uppdateringen ger bland annat bättre stöd för RISC-V, nya möjligheter vid felsökning och snabbare länkning av stora program.

    GNU-projektet har släppt GNU Binutils 2.47, en ny version av den verktygssamling som används för att bygga, länka och undersöka program på Linux och andra Unixliknande operativsystem.

    Binutils arbetar oftast i bakgrunden och märks därför sällan av vanliga datoranvändare. För programmerare, systemutvecklare och skapare av Linuxdistributioner är verktygen däremot mycket viktiga. De används tillsammans med bland annat kompilatorn GCC, standardbiblioteket glibc och felsökaren GDB.

    Vad är GNU Binutils?

    När en programmerare skriver ett program måste källkoden gå igenom flera steg innan den kan köras av datorn.

    Först översätts programkoden till maskinkod. Därefter måste olika delar av programmet kopplas samman till en färdig körbar fil. Binutils innehåller flera av de verktyg som behövs under denna process.

    Bland de mest kända verktygen finns:

    • as – omvandlar assemblerkod till objektfiler.
    • ld – länkar samman objektfiler och bibliotek till färdiga program.
    • objdump – visar information om innehållet i körbara filer och objektfiler.
    • readelf – granskar ELF-filer, som är det vanligaste formatet för körbara program i Linux.
    • ar – skapar och hanterar statiska programbibliotek.

    De flesta utvecklare använder inte alla dessa kommandon direkt. I stället anropas de automatiskt av kompilatorer och byggsystem.

    Enklare felsökning av program

    Både objdump och readelf har fått det nya alternativet:

    --debug-dir=DIR

    Det gör det möjligt att ange en särskild katalog där verktygen ska leta efter separata filer med felsökningsinformation.

    Felsökningsinformation innehåller exempelvis funktionsnamn, variabelnamn och kopplingar mellan maskinkod och programmets ursprungliga källkod. Informationen är mycket användbar när ett program kraschar eller beter sig fel.

    I många Linuxdistributioner lagras felsökningsinformationen separat från själva programmet. Det gör programfilerna mindre, samtidigt som utvecklare fortfarande kan installera den mer detaljerade informationen när den behövs.

    Med det nya alternativet blir det enklare att undersöka program när felsökningsfilerna ligger på en annan plats än normalt.

    Objdump kan visa globala variabler

    Verktyget objdump har även fått alternativet:

    --map-global-vars

    Det kan användas för att visa var globala variabler finns i en objektfil och vilken typ av information de innehåller.

    En global variabel är en variabel som kan användas av flera delar av ett program. Sådana variabler kan ibland göra program svårare att felsöka, eftersom innehållet kan ändras från många olika platser.

    Den nya funktionen kan därför hjälpa utvecklare att förstå hur ett program använder sitt minne och hur olika variabler är placerade i den färdiga programfilen.

    Objektfiler kan behandlas som ett bibliotek

    Länkaren har fått stöd för alternativen:

    --start-lib

    --end-lib

    De gör det möjligt att behandla en grupp objektfiler ungefär som om de låg i ett statiskt bibliotek.

    Ett statiskt bibliotek är normalt en samling färdigkompilerade objektfiler som har packats ihop i en arkivfil. Med de nya alternativen behöver utvecklaren inte alltid skapa en sådan arkivfil först.

    Det kan förenkla byggprocessen, särskilt i stora projekt där många mindre objektfiler ska kopplas samman.

    Länkaren tar då endast med de objektfiler som verkligen behövs, på ungefär samma sätt som när ett vanligt statiskt bibliotek används.

    Snabbare länkning kan ge större programfiler

    BFD-länkaren stöder nu optimeringsnivån:

    -O 0

    När denna nivå används slutar länkaren att slå samman innehållet i vissa sektioner som innehåller identiska eller liknande data.

    Normalt försöker länkaren minska storleken på det färdiga programmet genom att kombinera exempelvis identiska textsträngar eller annan återkommande information.

    Det arbetet kan dock ta tid, särskilt när mycket stora program ska byggas.

    Genom att använda -O 0 kan länkningen därför gå betydligt snabbare. Nackdelen är att det färdiga programmet kan bli större eftersom information som hade kunnat delas i stället sparas flera gånger.

    Det blir alltså en avvägning mellan byggtid och filstorlek.

    Funktionen kan vara särskilt användbar under utveckling, när ett program kompileras och länkas om många gånger. Inför en slutlig utgåva kan utvecklaren sedan välja en högre optimeringsnivå för att skapa en mindre programfil.

    Förbättrat stöd för RISC-V

    GNU Binutils 2.47 utökar även stödet för processorarkitekturen RISC-V.

    RISC-V är en öppen processorarkitektur. Till skillnad från flera traditionella processorplattformar kan den användas och vidareutvecklas utan att tillverkare behöver betala licensavgifter för själva instruktionsuppsättningen.

    Arkitekturen används bland annat i mikrokontroller, inbyggda system, forskningsprojekt, servrar och experimentella persondatorer.

    Den nya versionen av Binutils innehåller stöd för flera ytterligare RISC-V-utökningar, däribland:

    • zalasr 1.0
    • svrsw60t59b 1.0
    • zvabd 1.0
    • smpmpmt 1.0

    Stöd har också lagts till för flera instruktioner som utför vektoriella punktprodukter.

    Vektorberäkningar gör det möjligt för processorn att bearbeta flera tal samtidigt i stället för ett tal i taget. Det är särskilt användbart inom områden som bildbehandling, artificiell intelligens, vetenskapliga beräkningar och signalbehandling.

    Punktprodukter är en vanlig matematisk operation inom exempelvis maskininlärning. Bättre stöd för sådana instruktioner gör det möjligt för utvecklare att skapa program som mer effektivt utnyttjar moderna RISC-V-processorer.

    Äldre 32-bitars S/390 fasas ut

    Stödet för den 32-bitars IBM S/390-plattformen har nu markerats som föråldrat.

    Det innebär inte nödvändigtvis att stödet försvinner omedelbart, men det är en tydlig signal om att det kan tas bort i en framtida version.

    Den modernare 64-bitarsarkitekturen S/390x påverkas inte. Den fortsätter att stödjas och underhållas.

    S/390 och S/390x används främst i IBM:s stordatorsystem. Att den äldre 32-bitarsversionen fasas ut är därför ett naturligt steg när allt fler system använder 64-bitarsprocessorer och modernare programvara.

    En viktig uppdatering som arbetar i bakgrunden

    GNU Binutils 2.47 innehåller inga funktioner som vanliga datoranvändare kommer att se direkt på skrivbordet. Uppdateringen är ändå betydelsefull.

    Nästan alla program i en Linuxdistribution har vid något tillfälle passerat genom en assembler, länkare eller något annat verktyg från Binutils.

    Förbättringarna kan ge utvecklare snabbare byggprocesser, bättre möjligheter att undersöka programfiler och utökat stöd för nya processorinstruktioner.

    GNU Binutils 2.47 finns tillgänglig som källkod från GNU-projektets servrar. Användare av Linuxdistributioner med löpande uppdateringar kan räkna med att versionen dyker upp i pakethanteraren när distributionernas utvecklare har hunnit testa och paketera den.

    https://lists.gnu.org/archive/html/info-gnu/2026-07/msg00006.html

    Fakta: GNU Binutils 2.47

    • Utvecklare: GNU-projektet
    • ”`
    • Typ av programvara: Verktyg för assemblering, länkning och analys av binära filer
    • Viktiga verktyg: as, ld, objdump, readelf och ar
    • Nyheter: Förbättrad felsökning, nya länkaralternativ och snabbare länkning
    • Processorstöd: Utökat stöd för flera nya RISC-V-instruktioner
    • Utfasning: Stödet för 32-bitars IBM S/390 har markerats som föråldrat
    • Licens: Fri programvara inom GNU-projektet
    • ”`
  • Codeberg säger nej till projekt som huvudsakligen skapats av AI

    Den ideella kodplattformen Codeberg förbjuder nu projekt som till största delen består av AI-genererad kod. Beslutet grundas på osäker upphovsrätt, säkerhetsrisker och svårigheten att avgöra vem som egentligen ansvarar för programvaran.

    Den ideella kodplattformen Codeberg inför nya regler för programvara som har skapats med hjälp av generativ artificiell intelligens. Projekt där merparten av källkoden har skrivits av AI-verktyg får inte längre lagras på plattformen.

    Codeberg är en tjänst för fri programvara och projekt med öppen källkod. Plattformen drivs utan vinstsyfte och bygger på programvaran Forgejo, som är ett öppet alternativ till bland annat GitHub.

    Den nya begränsningen har lagts till i Codebergs användarvillkor efter att frågan diskuterats och godkänts genom organisationens gemensamma beslutsprocess. Regeln omfattar kod som huvudsakligen har skapats av generativa AI-tjänster, exempelvis Claude och OpenAI Codex.

    Oklart vem som äger AI-skapad kod

    Ett av Codebergs viktigaste argument handlar om upphovsrätt.

    Generativa AI-system tränas på mycket stora mängder text och programkod. I många fall är det svårt att veta exakt vilket material som har använts vid träningen och vilka licenser som gäller för det ursprungliga materialet.

    Det skapar flera obesvarade frågor. Kan AI-genererad kod innehålla delar som liknar upphovsrättsskyddad kod? Vem bär ansvaret om sådan kod publiceras? Kan den som använder AI-verktyget verkligen ge programmet en giltig licens?

    Codeberg anser att den juridiska situationen fortfarande är för osäker för att plattformen ska tillåta projekt som till största delen består av AI-genererat innehåll.

    Risk för skadlig och osäker kod

    Codeberg lyfter även fram säkerheten.

    Ett generativt AI-system förstår inte programkod på samma sätt som en erfaren utvecklare. Systemet skapar i stället svar genom att beräkna vilka ord, symboler och kodrader som sannolikt bör följa efter varandra.

    Resultatet kan se korrekt och professionellt ut, trots att programmet innehåller allvarliga fel. Det kan exempelvis handla om säkerhetshål, felaktig hantering av lösenord eller kod som använder gamla och osäkra funktioner.

    AI-verktyg kan dessutom producera skadlig kod, antingen avsiktligt efter en instruktion eller oavsiktligt genom ett felaktigt förslag. Enligt Codeberg har dagens AI-tjänster inte tillräckligt starka skydd för att garantera att större automatiskt skapade projekt är säkra.

    I användarvillkoren skriver Codeberg att användare inte får dela projekt som huvudsakligen består av kod skriven av generativa AI-verktyg. Som skäl anges både den oklara upphovsrätten och risken för skadligt innehåll.

    All användning av AI förbjuds inte

    Den nya regeln innebär inte att utvecklare helt måste avstå från AI.

    Det är fortfarande tillåtet att använda AI som ett begränsat hjälpmedel. En programmerare kan exempelvis be ett AI-system att förklara ett felmeddelande, föreslå hur en enskild funktion kan förbättras eller hjälpa till att skriva dokumentation.

    Begränsningen gäller projekt där AI har producerat huvuddelen av själva källkoden.

    Gränsen är dock inte särskilt tydlig. Codeberg har inte angett någon exakt procentsats för hur stor del av ett projekt som får vara AI-genererad. Det framgår inte heller hur kod som har skapats gemensamt av människor och AI ska bedömas.

    Mänsklig granskning verkar inte räcka

    Reglernas formulering innehåller inget tydligt undantag för kod som först har skapats av AI och därefter granskats av en människa.

    Det innebär att ett projekt kan omfattas av förbudet även om utvecklaren har läst, testat och förstått varje kodrad. Den avgörande frågan verkar vara vem eller vad som ursprungligen skapade huvuddelen av koden.

    Detta kan bli svårt att hantera i praktiken. Modern programutveckling sker ofta i flera steg. En utvecklare kan låta AI skapa ett första förslag, ändra stora delar av det och sedan bygga vidare manuellt.

    När är koden då fortfarande AI-genererad? Codebergs regler ger ännu inget tydligt svar.

    Svårt att upptäcka AI-skriven kod

    Det finns i dag ingen helt pålitlig metod för att avgöra om ett program har skrivits av en människa eller av ett AI-system.

    Till skillnad från bilder och vanlig text innehåller programkod ofta fasta strukturer och återkommande lösningar. Två utvecklare kan därför skriva mycket liknande kod utan att någon har kopierat den andra.

    AI-genererad kod kan också redigeras, döpas om och blandas med mänskligt skriven kod. Efter tillräckligt många ändringar kan det vara nästan omöjligt att fastställa hur den första versionen skapades.

    Codeberg har ännu inte förklarat hur plattformen ska upptäcka regelbrott eller vilken typ av bevis som kommer att krävas.

    Det är därför möjligt att reglerna främst kommer att användas mot projekt som öppet beskriver sig som helt eller nästan helt AI-genererade.

    En annan väg än GitHub

    Codebergs beslut går i motsatt riktning jämfört med utvecklingen hos den kommersiella konkurrenten GitHub.

    GitHub har under de senaste åren byggt in allt fler AI-funktioner för programmerare. AI-assistenter kan föreslå kod, besvara frågor om projekt och i vissa fall arbeta mer självständigt med programmeringsuppgifter.

    Medan GitHub ser generativ AI som en central del av framtidens programutveckling väljer Codeberg alltså att dra en tydlig gräns.

    Skillnaden speglar två olika synsätt. Det ena betonar snabbare utveckling och automatisering. Det andra lägger större vikt vid upphovsrätt, säkerhet, mänsklig kontroll och möjligheten att förstå hur ett program har skapats.

    Kan påverka fler plattformar

    Codebergs beslut är ett av de tydligaste exemplen hittills på en kodplattform som begränsar AI-genererad programvara i sina användarvillkor.

    Plattformen nöjer sig inte med att rekommendera försiktighet eller kräva att AI-användning redovisas. Projekt som huvudsakligen har skapats av generativ AI måste i stället publiceras någon annanstans.

    Det återstår att se hur reglerna kommer att fungera i praktiken. Codeberg behöver bland annat avgöra vad ordet ”huvudsakligen” betyder, hur misstänkta projekt ska granskas och hur utvecklare ska kunna försvara sig mot felaktiga anklagelser.

    Beslutet visar samtidigt att frågan om AI-genererad kod inte bara är teknisk. Den handlar även om juridiskt ansvar, säkerhet, förtroende och vilken roll människor ska ha i framtidens programutveckling.

    https://codeberg.org/Codeberg/org/pulls/1253/commits/96fac426a32d1ba91ff879366d59bf1af54080c2

    Fakta: Codebergs nya AI-regel

    Plattform: Codeberg

    Inriktning: Ideell Git-plattform för fri programvara och projekt med öppen källkod.

    Ny regel: Projekt som huvudsakligen består av kod skapad med generativa AI-verktyg får inte längre publiceras på plattformen.

    Exempel på AI-verktyg: Claude och OpenAI Codex.

    Codebergs motivering: AI-genererad kod kan ha oklar upphovsrättslig status och innehålla säkerhetsproblem eller skadlig kod.

    Begränsad AI-hjälp: Det är fortfarande tillåtet att använda AI som hjälpmedel, så länge AI inte har skapat huvuddelen av projektets kod.

    Oklart: Codeberg har ännu inte förklarat exakt hur AI-genererad kod ska identifieras eller hur ordet ”huvudsakligen” ska bedömas.

  • Perl 5.44 släppt – får namngivna parametrar, bättre prestanda och Unicode 17

    Perl 5.44 har släppts med experimentellt stöd för namngivna parametrar, förbättrad prestanda och stöd för Unicode 17. Den nya versionen innehåller även flera säkerhetsrättningar, strängare regler för Unicode-tecken och uppdateringar av språkets reguljära uttryck.

    Programmeringsspråket Perl har fått en ny stabil version. Perl 5.44 innehåller bland annat experimentellt stöd för namngivna parametrar, bättre Unicode-hantering, flera prestandaförbättringar och rättningar av tre säkerhetsproblem.

    Perl har funnits sedan slutet av 1980-talet och används fortfarande för bland annat systemadministration, textbearbetning, webbapplikationer och automatisering. Språket är särskilt känt för sina kraftfulla funktioner för att söka, tolka och förändra text.

    Den nya versionen är den första stabila utgåvan i Perl 5.44-serien och kommer ungefär ett år efter Perl 5.42.

    Funktioner kan få namngivna parametrar

    En av de största nyheterna är experimentellt stöd för namngivna parametrar i funktioners signaturer.

    Traditionellt skickas argument till Perl-funktioner i en bestämd ordning. Funktionen måste alltså veta att det första värdet betyder en viss sak och att det andra värdet betyder något annat.

    Med namngivna parametrar kan anroparen i stället ange vad varje värde representerar. Det kan göra koden tydligare, särskilt i funktioner som tar emot många argument.

    I stället för att bara skicka flera värden efter varandra kan programmeraren exempelvis ange namn som name, age eller address.

    Funktionen är fortfarande experimentell. Det innebär att syntaxen och beteendet kan förändras i framtida Perl-versioner.

    Flera variabler i samma loop

    Perl 5.44 kombinerar även två andra experimentella funktioner: loopar med flera variabler och referensalias.

    Det gör det möjligt att behandla flera relaterade värden under varje varv i en loop. En variabel kan samtidigt fungera som ett direkt alias till den ursprungliga informationen.

    Det kan vara praktiskt när ett program exempelvis går igenom par bestående av en nyckel och en arrayreferens. Ändringar som görs genom aliaset kan då påverka den ursprungliga datastrukturen direkt.

    De funktioner som krävs, refaliasing och declared_refs, är fortfarande experimentella och måste aktiveras uttryckligen.

    Tydligare reguljära uttryck

    Reguljära uttryck är mönster som används för att söka efter eller bearbeta text. De är en central del av Perl och används ofta för exempelvis loggfiler, konfigurationsfiler och automatiserad textanalys.

    Perl har sedan tidigare modifieraren /xx, som gör det möjligt att formatera reguljära uttryck över flera rader och lägga till kommentarer.

    I Perl 5.44 har denna funktion byggts ut genom det experimentella tillägget enhanced_xx. Teckenklasser inom hakparenteser kan nu delas upp på flera rader och innehålla kommentarer.

    Perl kan också varna när delar av ett reguljärt uttryck verkar ha tolkats som en kommentar av misstag.

    Samtidigt införs strängare regler. Ett #-tecken som inte föregås av ett omvänt snedstreck, eller radbrytningar som skrivs direkt inne i en teckenklass, betraktas nu som föråldrad syntax.

    Äldre uttryck fortsätter tills vidare att fungera, men ger varningar. De bör uppdateras genom att exempelvis skriva \# eller använda en särskild sekvens som \n.

    Stöd för Unicode 17

    Perl 5.44 uppdaterar sitt stöd till Unicode 17.0.

    Unicode är den internationella standard som gör det möjligt för datorer att hantera bokstäver, symboler och skriftsystem från stora delar av världen. Den omfattar allt från svenska tecken till arabiska, kinesiska, matematiska symboler och emoji.

    Den nya Perl-versionen följer Unicode-reglerna mer strikt när tecken används i namn på variabler, funktioner, paket och namngivna grupper i reguljära uttryck.

    Omkring 160 ovanliga tecken som tidigare accepterades av Perls bredare tolkning av \w får inte längre användas i sådana namn. Anledningen är att de inte uppfyller Unicode-egenskaperna XID_Start och XID_Continue, som definierar vilka tecken som bör få inleda eller fortsätta ett programmeringsnamn.

    För de flesta programmerare får ändringen ingen märkbar effekt. Program som använder mycket ovanliga Unicode-tecken i namn kan däremot behöva ändras före en uppgradering.

    Tre säkerhetsproblem har rättats

    Perl 5.44 innehåller rättningar för tre rapporterade sårbarheter.

    Den första, CVE-2026-8376, berör en felaktig beräkning av buffertstorlek i funktionen Perl_study_chunk. På 32-bitarsystem kunde felet orsaka heltalsöverflöde och leda till att data skrevs utanför det avsedda minnesområdet.

    Den andra sårbarheten, CVE-2026-57432, påverkar hanteringen av mycket stora datastrukturer i funktionerna pack och unpack. Ett extremt stort repetitionsvärde kunde orsaka heltalsöverflöde och därefter buffertöverflöde.

    Det tredje problemet, CVE-2026-13221, finns i reguljära uttrycksmotorns optimering av stora alternativlistor. Reguljära uttryck med fler än ungefär 65 000 alternativa grenar kunde fylla ett 16-bitarsfält och i vissa fall ge felaktiga matchningar.

    Slumptalen får bättre startvärden

    Perl ändrar även hur språkets interna slumptalsgenerator startas.

    På Linux, BSD och macOS försöker Perl nu i första hand använda systemanropet getentropy(). Om det inte är tillgängligt används /dev/urandom. Som sista reserv används ett hashvärde som bygger på programmets interna tillstånd.

    Detta ger bättre och mer oförutsägbara startvärden än tidigare lösningar.

    Perl-utvecklarna betonar dock att funktionen rand fortfarande inte är avsedd för kryptografi, lösenord, säkerhetstokens eller andra säkerhetskritiska ändamål. Sådana program bör använda en särskild kryptografiskt säker slumptalsgenerator.

    Vissa operationer går snabbare

    Perl 5.44 innehåller flera mindre prestandaförbättringar.

    Heltalsaddition, subtraktion och multiplikation kan nu utföras något snabbare på system där kompilatorn har stöd för de optimeringar som behövs.

    Det har även blivit snabbare att skapa hash-tabeller från listor där nycklarna består av konstanta textsträngar som redan är kända när programmet kompileras.

    Behandlingen av funktionssignaturer har också optimerats. Funktioner som använder signaturer får därför något lägre belastning när de anropas.

    Varje enskild förbättring är relativt liten, men tillsammans kan de ge märkbara vinster i större program eller kod som körs mycket ofta.

    Gammalt beteende tas bort

    Perl 5.44 tar även bort ett beteende som varit markerat som föråldrat sedan Perl 5.12.

    Det är inte längre tillåtet att använda goto för att hoppa direkt in i en loop eller ett kodblock från utsidan.

    Sådana hopp kan göra ett programs körning svår att förutsäga eftersom de kringgår den normala vägen in i kodblocket. Förändringen gör språket mer konsekvent och minskar risken för svårfunna fel.

    Perl 5.40 har nått slutet av sin supportperiod

    I samband med att Perl 5.44 släpps avslutas den officiella supporten för Perl 5.40-serien.

    Den som fortfarande använder Perl 5.40 bör därför planera en uppgradering. Äldre Perl-program bör testas noggrant, särskilt om de använder experimentella funktioner, ovanliga Unicode-tecken eller avancerade reguljära uttryck.

    Nästa utvecklingsversion väntas bli Perl 5.45.1. Den kommer att ligga till grund för nästa stabila huvudversion, som enligt planerna ska släppas under första halvåret 2027.

    Perl 5.44 är ingen dramatisk ombyggnad av språket, men versionen moderniserar flera viktiga delar. Namngivna parametrar kan göra funktioner enklare att förstå, Unicode-stödet blir mer korrekt och flera vanliga operationer har effektiviserats.

    Samtidigt visar säkerhetsrättningarna varför det är viktigt att hålla även mogna och väletablerade programmeringsspråk uppdaterade.

    https://www.nntp.perl.org/group/perl.perl5.porters/2026/07/msg271063.html

    $ teknisk_fakta –perl-5.44
    Version: Perl 5.44
    Typ: Stabil produktionsversion
    Licens: Artistic License eller GNU GPL
    Unicode: Unicode 17.0
    Viktig nyhet: Experimentellt stöd för namngivna parametrar i funktionssignaturer
    Reguljära uttryck: Utökat stöd för läsbara uttryck med /xx och enhanced_xx
    Prestanda: Snabbare heltalsoperationer, hash-skapande och behandling av signaturer
    Säkerhet: Tre säkerhetsproblem har rättats
    Slumptal: Förbättrad initiering via getentropy() och /dev/urandom
    Support: Perl 5.40-serien har nått slutet av sin supportperiod
    Webbplats: perl.org
    root@linux:~$ perl -v
  • Linus Torvalds: Från programmerare till utvecklingsledare

    Linus Torvalds skriver numera sällan kod själv och beskriver sin roll som utvecklingsledare. Under Open Source Summit India 2026 berättade han om arbetet bakom Linuxkärnan, synen på AI och Rust samt varför föråldrad teknik ibland måste tas bort.

    Linus Torvalds skriver numera sällan kod själv. I stället leder han utvecklingen av Linuxkärnan genom att granska större förändringar, samordna utvecklare och fatta beslut om projektets inriktning.

    Under Open Source Summit India 2026 berättade han att Git och e-post fortfarande är hans viktigaste verktyg. Arbetet handlar i dag mer om människor, prioriteringar och helhet än om enskilda kodrader.

    Linux utvecklas stegvis, med nya kärnversioner ungefär varannan månad. Torvalds föredrar små förbättringar framför stora och riskfyllda förändringar. Han är särskilt försiktig med sena rättningar, eftersom även mindre ändringar kan skapa nya problem.

    Enligt Torvalds är mänskliga konflikter ofta svårare att lösa än tekniska fel. Kod kan rättas, medan problem med kommunikation och samarbete kan bli betydligt mer komplicerade.

    Han anser också att Linux inte kan stödja all gammal hårdvara för alltid. Teknik som inte längre används måste ibland tas bort för att minska mängden kod som behöver underhållas.

    Rust är enligt Torvalds ett viktigt tillskott, men inget fullständigt skydd mot fel. Språket kan förhindra vissa minnesproblem, men inte logiska misstag. Därför kommer C även fortsättningsvis att spela en viktig roll i Linuxkärnan.

    AI-verktyg används allt mer för att hitta buggar och granska kod. Samtidigt har de skapat felaktiga rapporter och ytliga lösningar. Torvalds anser därför att människor alltid måste kontrollera och ansvara för AI-genererade bidrag.

    Han använder själv AI för mindre experiment och prototyper, men anser ännu inte att tekniken är tillräckligt pålitlig för att självständigt skriva kod till Linuxkärnan.

    Torvalds främsta uppgift är numera inte att programmera, utan att se till att tusentals utvecklares arbete tillsammans leder till en stabil och långsiktigt hållbar Linuxkärna.

    https://www.zdnet.com/article/open-source-summit-linus-torvalds

  • När Linux sätter gränser för vad som är en säkerhetsbugg

    När antalet AI-genererade sårbarhetsrapporter ökar vill Linuxprojektet dra en tydligare gräns mellan vanliga buggar och verkliga säkerhetshål. Linus Torvalds har nu slagit ihop ny dokumentation som förklarar när ett fel i Linuxkärnan ska behandlas som en säkerhetsbugg, hur rapporter bör skickas in och varför spekulativa AI-fynd inte får belasta säkerhetsteamet i onödan. Resultatet är en mer praktisk hotmodell för Linux – och ett försök att skilja allvarliga angreppsvägar från brus, teorier och dåligt testade rapporter.

    Linuxkärnan är ett av världens viktigaste mjukvaruprojekt. Den används i allt från mobiltelefoner och servrar till routrar, bilar, molntjänster och superdatorer. Därför är frågan om säkerhetsbuggar i Linux inte bara en teknisk detalj för utvecklare, utan något som i förlängningen påverkar stora delar av det digitala samhället.

    Nu har Linus Torvalds slagit ihop ny dokumentation i Linuxkärnan som tydligare förklarar vad som faktiskt räknas som en säkerhetsbugg, hur sådana buggar bör rapporteras och hur utvecklare ska hantera rapporter som tagits fram med hjälp av AI. Dokumentationen ingår i ändringarna för docs-7.1-fixes och bygger bland annat på arbete av Willy Tarreau, känd från HAProxy och underhåll av stabila Linuxkärnor.

    Alla buggar är inte säkerhetshål

    En central poäng i den nya dokumentationen är att inte alla fel i kärnan ska betraktas som säkerhetshål. Linuxprojektet vill i första hand att vanliga buggar ska hanteras öppet, på publika e-postlistor och i den normala utvecklingsprocessen.

    Det finns en praktisk orsak till detta. När fler utvecklare kan läsa, granska och testa en lösning ökar chansen att felet rättas på ett bra sätt. Om en bugg däremot behandlas bakom stängda dörrar av en liten grupp personer finns större risk att viktiga användningsfall missas eller att lösningen inte blir tillräckligt testad.

    Den privata säkerhetslistan är därför tänkt för särskilt allvarliga fall: buggar som är lätta att utnyttja, påverkar många användare och ger en angripare rättigheter som denne inte borde ha på ett korrekt konfigurerat produktionssystem.

    Med andra ord: ett fel blir inte automatiskt ett säkerhetshål bara för att det kan krascha något eller ser farligt ut i teorin. Det avgörande är om felet passerar en verklig säkerhetsgräns.

    Linux får en tydligare hotmodell

    En viktig del av förändringen är att Linuxkärnan nu får en mer uttalad hotmodell. En hotmodell beskriver vad systemet ska skydda mot, men också vad det inte kan eller inte lovar att skydda mot.

    Linuxkärnan ska bland annat skydda användare från varandra på samma system. En vanlig användare ska inte kunna läsa andra användares filer, komma åt deras processminne, spionera på deras processer eller kringgå skydd som styr nätverk och kommunikation.

    Kärnan ska också upprätthålla skydd baserade på så kallade capabilities, alltså särskilda behörigheter som CAP_SYS_ADMIN, CAP_NET_ADMIN och CAP_SYS_PTRACE. En användare utan rätt behörighet ska exempelvis inte kunna ändra nätverksinställningar, manipulera andra användares processer eller påverka kärnans tillstånd.

    Om en bugg gör att en vanlig användare kan få en sådan behörighet, eller göra något som normalt kräver administratörsrättigheter, kan det röra sig om en riktig säkerhetsbugg.

    AI-rapporter har blivit ett problem

    Den nya dokumentationen tar också upp ett modernt problem: AI-assisterade sårbarhetsrapporter.

    AI-verktyg kan vara användbara för att hitta misstänkta buggar i kod, särskilt i gamla eller ovanliga delar av kärnan. Men enligt dokumentationen har många rapporter som skickas till säkerhetsteamet blivit för långa, för spekulativa eller helt enkelt för dåligt verifierade.

    Problemet är inte att AI används. Problemet är när AI-genererade rapporter skickas in utan att någon människa har kontrollerat om felet verkligen går att återskapa, om det har säkerhetspåverkan eller om den föreslagna exploiten faktiskt fungerar.

    Därför säger den nya vägledningen att buggar som hittats med AI normalt ska behandlas som offentliga. Skälet är att flera personer ofta hittar samma typ av AI-upptäckta fel samtidigt. Däremot ska fungerande exploitkod inte publiceras öppet. Rapportören kan i stället säga att en reproducerbar exploit finns och lämna den privat om en ansvarig underhållare ber om det.

    Rapporter ska vara korta, tydliga och testade

    Linuxutvecklarna efterfrågar nu mer disciplinerade rapporter. En bra rapport ska vara kort, skriven i ren text och börja med det viktigaste: vilken fil eller funktion som påverkas, vilka versioner som berörs och vilken konkret påverkan felet har.

    Det räcker inte att skriva att ett fel “kan leda till privilegieeskalering” om det inte är visat. Rapportören bör i stället beskriva vad som faktiskt har testats. Till exempel: kan en vanlig användare få CAP_NET_ADMIN? Kan en process läsa minne den inte ska komma åt? Går felet att återskapa på en normal installation?

    AI-genererade reproducerare ska testas innan de skickas in. Om en AI påstår att en exploit fungerar, men rapportören inte själv har kontrollerat det, riskerar rapporten att ignoreras. Dokumentationen uppmuntrar också till att använda AI för att föreslå och testa fixar, inte bara för att producera fler felrapporter.

    Vad räknas inte som säkerhetsbugg?

    Den nya dokumentationen listar flera typer av problem som normalt inte ska ses som säkerhetshål i Linuxkärnan.

    Det gäller till exempel buggar i gamla, icke-underhållna kärnversioner. Administratörer förväntas hålla sina system uppdaterade, och en sårbarhet måste visas påverka aktivt underhållna versioner för att behandlas som en aktuell säkerhetsfråga.

    Det gäller också osäkra eller ovanliga konfigurationer. Om någon själv har ändrat sysctl-inställningar, filrättigheter eller byggt kärnan med alternativ som uttryckligen sänker säkerheten, är det inte självklart en kärnsårbarhet när något går fel.

    Utvecklingsfunktioner som LOCKDEP, KASAN och FAULT_INJECTION räknas inte heller som produktionsskydd. De är till för testning och felsökning, och kan i sig påverka stabilitet och prestanda.

    Inte heller buggar som kräver orimliga laboratorieförhållanden, modifierad hårdvara, miljarder försök eller redan mycket höga rättigheter ska automatiskt betraktas som säkerhetshål.

    Root som kraschar systemet är inte alltid en sårbarhet

    En annan viktig princip är att åtgärder som kräver full administratörsbehörighet sällan är säkerhetsbuggar i sig. Om root-användaren i den ursprungliga namnrymden kan skriva till en privilegierad enhet och orsaka en kernel oops, är det normalt inte en säkerhetsgräns som brutits. Root hade redan makten att påverka systemet.

    Det Linuxprojektet fokuserar på är i stället när en användare får mer makt än den borde ha. Säkerhetsfrågan uppstår alltså när någon passerar en gräns mellan rättigheter, inte när någon redan har rättigheterna och använder dem på ett destruktivt sätt.

    Användarnamnrymder får särskild förklaring

    Dokumentationen tar även upp CONFIG_USER_NS, alltså stöd för användarnamnrymder. Med denna funktion kan en vanlig användare skapa en isolerad miljö där användaren till synes har fulla rättigheter inom just den miljön.

    Det betyder dock inte att användaren ska kunna påverka hela systemet. En sådan namnrymd får inte ge möjlighet att ändra global systemtid, ladda kärnmoduler, montera blockenheter eller påverka den ursprungliga namnrymden på otillåtet sätt.

    Här blir hotmodellen viktig. En bugg är allvarlig om den gör att isoleringen mellan namnrymder bryts.

    Debuggning är inte alltid tänkt för vanliga användare

    Linux innehåller många kraftfulla verktyg för felsökning och prestandaanalys. Exempel är /proc/kmsg, perf, tracing och debugfs. Dessa kan ge djup insyn i systemet och därmed också bli riskabla om de exponeras fel.

    Den nya dokumentationen betonar att vissa sådana gränssnitt kräver uttryckligt administratörsbeslut. Om en administratör själv ger användare tillgång till känsliga debuggränssnitt är det inte nödvändigtvis ett säkerhetshål i kärnan. Det är en konfigurationsfråga.

    Målet är mindre brus och bättre fixar

    Bakgrunden till förändringen är tydlig: Linuxprojektet vill minska mängden felrapporter som felaktigt märks som säkerhetskritiska. Varje rapport som hamnar fel tar tid från utvecklare och säkerhetsteam. Det gör att verkligt allvarliga problem riskerar att drunkna i brus.

    Samtidigt stänger dokumentationen inte dörren för osäkra fall. Om en rapportör verkligen är osäker på om ett fel är en säkerhetsbugg uppmanas denne fortfarande att rapportera privat. Hellre en extra granskning av ett gränsfall än att en verklig sårbarhet missas.

    Men budskapet är tydligt: kalla inte varje bugg för ett säkerhetshål. Visa vilken säkerhetsgräns som bryts, testa reproduceraren, håll rapporten kort och skicka vanliga buggar till den vanliga utvecklingsprocessen.

    En mognare syn på säkerhet i en AI-tid

    Det här är mer än en intern dokumentationsändring. Det visar hur stora öppna källkodsprojekt anpassar sig till en ny verklighet där AI kan massproducera analyser, hypoteser och rapporter.

    AI kan hjälpa till att hitta riktiga fel. Men den kan också skapa stora mängder halvfärdiga påståenden som människor måste granska. För ett projekt som Linux, där underhållarnas tid är en begränsad resurs, blir kvaliteten på rapporterna avgörande.

    Den nya dokumentationen försöker därför sätta en rimlig balans. Säkerhet ska tas på allvar, men säkerhetsprocessen ska inte överbelastas av spekulationer, dåligt testade AI-fynd eller buggar som egentligen hör hemma i den öppna utvecklingsprocessen.

    I praktiken handlar det om något mycket grundläggande: ett säkerhetshål är inte bara ett fel i kod. Det är ett fel som bryter ett skydd som systemet har lovat att upprätthålla. Linuxprojektets nya dokumentation gör den gränsen tydligare.

    https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/commit/?id=36d49bba19f2c19c933d13b25dcf4eb607a030b3

    Teknisk faktaruta: Linuxkärnans nya säkerhetsdokumentation

    Ämne: Nya riktlinjer för säkerhetsbuggar i Linuxkärnan

    Infört av: Linus Torvalds via dokumentationsändringar i Linuxkärnan

    Pull request: docs-7.1-fixes

    Författare till dokumentationen: Willy Tarreau

    Syfte: Att tydliggöra vad som räknas som en säkerhetsbugg, hur rapporter ska skickas in och hur AI-assisterade buggrapporter ska bedömas.

    Viktiga nyheter:

    • Tydligare gräns mellan vanliga buggar och säkerhetsbuggar.
    • Ny hotmodell för Linuxkärnan.
    • Riktlinjer för AI-genererade och AI-assisterade rapporter.
    • Krav på testade reproducerare och verifierad påverkan.
    • Fokus på buggar som bryter verkliga säkerhetsgränser.

    Exempel på säkerhetspåverkan: En vanlig användare får behörigheter som normalt kräver administratörsrättigheter, exempelvis nätverkskontroll eller åtkomst till andra användares processer.

    Räknas normalt inte som säkerhetsbugg: Fel i gamla kärnversioner, osäkra specialkonfigurationer, utvecklingsfunktioner, teoretiska attacker utan fungerande exploit eller problem som kräver redan höga rättigheter.

    Betydelse: Dokumentationen ska minska brus i säkerhetsrapporteringen och hjälpa utvecklare att fokusera på verkligt allvarliga sårbarheter.

  • GCC 16.1 är här – och C++ tar ett stort kliv in i 2020-talet

    GCC 16.1 är här och markerar början på en ny fas för GNU Compiler Collection. Med C++20 som nytt standardläge, experimentellt stöd för kommande C++26-funktioner och förbättringar för både diagnostik, optimering och modern hårdvara är detta en release som kan få stor betydelse för utvecklare. Samtidigt kan äldre kodbaser behöva ses över när kompilatorn tar ett tydligt steg bort från C++17-eran.

    Den fria kompilatorsamlingen GCC har fått en ny storversion. Med GCC 16.1 startar den nya GCC 16-serien, och även om en kompilatorrelease kanske inte låter som något som får pulsen att rusa hos alla, är detta en version som många utvecklare kommer att märka av.

    Den största nyheten är att GCC nu byter standardläge för C++: från GNU C++17 till GNU C++20.

    Det betyder att den som kompilerar C++-kod utan att själv ange språkversion nu automatiskt får C++20 som utgångspunkt. För moderna projekt är det goda nyheter. För äldre kodbaser kan det däremot innebära att vissa saker behöver justeras.

    C++20 blir det nya normala

    C++20 var ett stort steg för programmeringsspråket C++. Det introducerade bland annat nya sätt att skriva generisk kod, förbättrade standardbibliotek och funktioner som gör språket mer uttrycksfullt. Att GCC nu gör GNU C++20 till standard är därför en tydlig signal: C++20 är inte längre något framtidsläge, utan något utvecklare bör räkna med i vardagen.

    För de flesta projekt innebär det inte nödvändigtvis katastrof. Men kod som byggts med antagandet att kompilatorn använder C++17 kan börja bete sig annorlunda eller ge nya felmeddelanden. Lösningen är ofta enkel: ange uttryckligen vilken standard projektet ska byggas med, till exempel med flaggan -std=gnu++17, eller uppdatera koden så att den fungerar bra med C++20.

    GCC-utvecklarna meddelar också att stödet för C++20:s standardbibliotek nu räknas som stabilt. Däremot är C++20-moduler fortfarande experimentella och kräver särskild aktivering med -fmodules.

    En försmak av C++26

    GCC 16.1 blickar också framåt. Versionen innehåller experimentellt stöd för flera funktioner som är på väg in i C++26, alltså en kommande version av C++-standarden.

    Bland nyheterna finns stöd för reflection, där program kan undersöka delar av sin egen struktur, contracts, som kan användas för att uttrycka krav och garantier i kod, constexpr exceptions, vilket stärker möjligheterna att göra beräkningar vid kompilering, samt nya bibliotekstyper som std::simd, std::inplace_vector, std::copyable_function och std::function_ref.

    Det här är inte funktioner man bör kasta in i produktionskritisk kod hur som helst. De är fortfarande experimentella. Men för språkintresserade utvecklare och verktygsmakare är GCC 16.1 ett viktigt steg mot nästa generation C++.

    Algol 68 gör oväntad entré

    En av de mer oväntade nyheterna är att GCC nu får en experimentell frontend för Algol 68, kallad ga68.

    Algol 68 är ett klassiskt programmeringsspråk från datorhistoriens mer akademiska hörn. Det hade stort inflytande på senare språk, även om det aldrig blev lika vardagligt använt som C, Pascal eller Fortran. Att GCC nu får stöd för Algol 68 är därför både tekniskt intressant och lite nostalgiskt.

    Frontend:en bygger på språket så som det beskrivs i den reviderade rapporten, inklusive godkända rättelser, och innehåller dessutom vissa GNU-utökningar samt en POSIX-prelude.

    Bättre felmeddelanden och modernare analys

    Kompilatorer handlar inte bara om att omvandla kod till körbara program. De är också ett av utvecklarens viktigaste verktyg för att förstå vad som gått fel.

    I GCC 16.1 har diagnostiken förbättrats. GCC kan nu generera fel- och varningsmeddelanden i ett experimentellt HTML-format, vilket kan göra rapporter mer lättlästa i webbläsare eller utvecklingsverktyg.

    Samtidigt förbättras SARIF-stödet med ny information om kontrollflöde. SARIF är ett format som används för maskinläsbara analysrapporter, till exempel i säkerhetsverktyg och CI-system.

    Det äldre JSON-formatet för diagnostik har tagits bort. Användare som behöver maskinläsbara felrapporter hänvisas i stället till SARIF.

    Mer stöd för moderna språkfunktioner

    På C-sidan utökas stödet för C23 och typen _BitInt till fler processorarkitekturer, bland annat RISC-V, Arm, S/390 och LoongArch. Det gör det enklare att skriva kod som arbetar med heltal av mer exakt definierade bitstorlekar.

    C-frontend:en får också stöd för så kallad counted-by-attribution för pekarfält, vilket kan hjälpa kompilatorn och analysverktyg att förstå hur stora vissa datastrukturer är.

    Fortran-användare får dessutom förbättringar i coarray-stödet. På system med en enda nod finns nu stöd för delat minne med flera trådar, vilket kan förbättra parallella Fortran-program.

    Snabbare kod genom bättre optimeringar

    Som vanligt i en ny GCC-version finns även en rad optimeringsförbättringar. GCC 16.1 har bland annat bättre vektorisering, alltså förmågan att omvandla kod så att processorn kan utföra flera operationer parallellt.

    Kompilatorn kan nu också vektorisera vissa loopar där antalet varv inte är känt i förväg, och hanteringen av reduktioner och tidiga loopavbrott har förbättrats.

    Även Link-Time Optimization, LTO, har fått förbättringar. LTO gör det möjligt för kompilatorn att optimera över flera källfiler när programmet länkas ihop. I GCC 16.1 hanteras top-level assembly bättre med hjälp av flaggan -flto-toplevel-asm-heuristics.

    Dessutom har spekulativ devirtualisering byggts ut, vilket kan hjälpa kompilatorn att optimera indirekta funktionsanrop när den kan göra kvalificerade gissningar om vilken funktion som faktiskt kommer att köras.

    Nya processorer och mer hårdvarustöd

    GCC 16.1 uppdaterar också stödet för ny hårdvara.

    På x86-sidan tillkommer stöd för AMD Zen 6 med -march=znver6, Intel Wildcat Lake med -march=wildcatlake och Intel Nova Lake med -march=novalake.

    För AMD GPU-offloading finns nu experimentellt stöd för MI300, och även LoongArch och IBM Z får ytterligare förbättringar.

    För vanliga användare märks detta kanske inte direkt. Men för den som bygger program för nya servrar, superdatorer eller specialiserad hårdvara kan kompilatorstöd vara avgörande för att få ut maximal prestanda.

    En version som kan kräva städning

    Som med många stora kompilatoruppdateringar finns en hake: kod som fungerade i tidigare GCC-versioner kan behöva ändras.

    Det beror både på den nya C++20-standarden som standardläge och på att kompilatorn blivit bättre på att upptäcka problem. I praktiken kan detta leda till fler varningar eller kompileringsfel i projekt som tidigare byggde utan problem.

    För utvecklare är rådet enkelt: testa tidigt, ange språkstandard tydligt i byggsystemet och läs igenom varningarna. Många av dem kan peka på verkliga problem som tidigare bara råkade passera obemärkt.

    Sammanfattning

    GCC 16.1 är mer än bara ännu en versionssiffra. Det är en tydlig markering om vart C++-världen är på väg. Med C++20 som nytt standardläge, experimentellt stöd för C++26, förbättrad diagnostik, bättre optimeringar och stöd för ny hårdvara är detta en viktig release för både systemutvecklare och språkentusiaster.

    För den som arbetar med äldre C++-kod gäller det att vara uppmärksam. För den som vill använda modernare språkfunktioner är GCC 16.1 däremot ett välkommet steg framåt.

    ”`html

    Faktaruta: GCC 16.1

    > Release: GCC 16.1 är den första stabila versionen i GCC 16-serien.

    > Största nyheten: C++ använder nu GNU C++20 som standard i stället för GNU C++17.

    > För utvecklare: Äldre projekt kan behöva ange språkstandard med exempelvis -std=gnu++17.

    > Framtidsstöd: Experimentellt stöd finns för flera C++26-funktioner.

    > Övrigt: GCC 16.1 innehåller även bättre diagnostik, optimeringar och stöd för ny hårdvara.

    ”`
  • Rust 1.95 släppt – större lyft för matchning, villkorsstyrd kod och standardbiblioteket

    Rust 1.95 är här med stöd för if let-guards i match, det nya makrot cfg_select! och en lång rad nya stabila API:er i standardbiblioteket. Releasen innebär också förändringar för custom targets och ytterligare uppdateringar i Cargo och Clippy.

    Rust 1.95 har nu släppts och bjuder på flera nyheter för utvecklare, bland annat förbättrad mönstermatchning, ett nytt makro för konfigurationsstyrd kompilering och en tydlig utökning av det stabila API:et i standardbiblioteket. Versionen publicerades den 16 april 2026.

    Den mest uppmärksammade språkförändringen är att if let-guards nu stöds i match-uttryck. Funktionen bygger vidare på let chains, som blev stabila i Rust 1.88, och gör det möjligt att lägga in ytterligare villkorlig mönstermatchning direkt i en matcharm. För utvecklare innebär det mer flexibel och kompakt kod i situationer där flera villkor behöver uttryckas samtidigt.

    Samtidigt betonar Rust-teamet att de mönster som fångas i en if let-guard ännu inte räknas in i kompilatorns analys av om en match är uttömmande. Det följer samma princip som vanliga if-guards redan gör i dag. Funktionen ger alltså större uttryckskraft, men inte någon förändring i hur exhaustiveness-kontrollen fungerar.

    En annan nyhet i Rust 1.95 är makrot cfg_select!, som enligt projektet fungerar som en slags kompileringstida match över cfg-predikat. Det placerar makrot i samma användningsområde som det välkända cfg-if-paketet, men med annan syntax och som en del av den stabila verktygskedjan. Syftet är att göra det enklare att välja olika implementationer beroende på plattform eller byggmiljö.

    Version 1.95 innebär också en bred utökning av Rusts stabila API-yta. Bland de nya stabiliserade delarna finns förbättringar för MaybeUninit, Cell, atomiska update– och try_update-metoder, core::range, samt nya metoder som Vec::push_mut och Vec::insert_mut. Även VecDeque, LinkedList och flera Layout-metoder får nya stabila tillskott.

    För användare som arbetar med mer specialiserade byggmiljöer innehåller releasen också en förändring kring egna target-specifikationer. Möjligheten att på stabil Rust skicka in en egen JSON-baserad target-fil direkt till rustc har tagits bort. Enligt Rust-projektet påverkar det dock inte användare med helt stabil verktygskedja i praktiken, eftersom byggande av standardbiblioteket för sådana custom targets redan tidigare krävde nightly-stöd.

    Utöver språk- och biblioteksförändringarna innehåller Rust 1.95 även fler uppdateringar i Cargo och Clippy. Sammantaget framstår versionen som en bred underhålls- och förbättringsrelease, snarare än en uppdatering med en enda dominerande nyhet. För Rust-utvecklare betyder det framför allt bättre ergonomi, fler stabila verktyg och ett fortsatt stegvis moget ekosystem.

    https://blog.rust-lang.org/2026/04/16/Rust-1.95.0

    Teknisk fakta: Rust 1.95
    Version Rust 1.95
    Typ av release Stabil språk- och biblioteksuppdatering
    Språknyhet Stöd för if let-guards i match-uttryck
    Nytt makro cfg_select!
    Biblioteksnyheter Utökad stabil API-yta i bland annat MaybeUninit, Cell, Vec, VecDeque och LinkedList
    Viktiga metoder Vec::push_mut, Vec::insert_mut, atomiska update/try_update
    Övrigt Stabilt stöd för custom JSON-targets i rustc tas bort
    Fokus Bättre ergonomi, fler stabila API:er och bred underhållsrelease
  • Ghostty 1.3 – snabb terminalemulator får stora nyheter

    Ghostty 1.3 är här med flera av de funktioner som användarna länge har efterfrågat. Den GPU-accelererade terminalemulatorn får nu bland annat sökning i terminalhistoriken, inbyggda systemanpassade scrollbars, bättre tangentbordsstyrning och smartare notiser, samtidigt som utvecklarna har förbättrat både prestanda och stabilitet.

    Terminalprogram är ett av de viktigaste verktygen i Linux- och utvecklarvärlden. Nu har den moderna terminalemulatorn Ghostty fått en omfattande uppdatering. Version 1.3 innehåller flera funktioner som länge har efterfrågats av användare, samtidigt som utvecklarna har förbättrat både prestanda och stabilitet.

    Ghostty är en relativt ny terminalemulator som fokuserar på hög prestanda genom att använda datorns grafikprocessor (GPU) för rendering. Resultatet är en snabb och responsiv terminal som klarar stora mängder text och komplexa terminalutdata utan att kännas långsam.

    Sök direkt i terminalens historik

    En av de största nyheterna i version 1.3 är sökning i scrollback-historiken. Tidigare har användare ofta behövt använda externa verktyg eller manuella metoder för att hitta text långt bak i terminalens logg.

    Nu går det att söka direkt i terminalen:

    • Ctrl + Shift + F på GTK-baserade system (vanligt i Linux)
    • Cmd + F på macOS

    När man söker markeras alla träffar direkt i terminalfönstret och man kan snabbt hoppa mellan resultaten via tangentbordet eller sökgränssnittet.

    Äkta scrollbars från operativsystemet

    Ghostty 1.3 introducerar också native scrollbars. Det innebär att rullningslisten inte längre är en specialritad komponent utan använder operativsystemets egna widgetar.

    Det ger flera fördelar:

    • Samma utseende som resten av systemet
    • Stöd för standardinteraktioner
    • Bättre integration i både Linux (GTK) och macOS

    Användaren kan till exempel dra i scrollbaren eller klicka i spåret för att hoppa i historiken, precis som i andra program.

    Klicka för att flytta markören i terminalprompten

    En annan efterlängtad funktion är click-to-move-cursor. Med hjälp av standarden OSC 133 Semantic Prompts specification kan användaren nu klicka i en aktiv shell-prompt för att flytta markören.

    Det gör terminalen mer lik en vanlig textredigerare. Istället för att använda piltangenter eller avancerade tangentkombinationer kan man helt enkelt klicka där man vill fortsätta skriva.

    Kraftfullare tangentbordsgenvägar

    För avancerade användare har Ghostty också förbättrat sitt system för tangentbordsbindningar.

    Nyheterna inkluderar:

    • Key tables – möjliggör modal arbetsstil liknande tmux
    • Kedjade kortkommandon – flera åtgärder från samma genväg
    • catch_all-tangent – fångar upp alla obundna tangenttryckningar i en sekvens

    Detta gör det enklare att skapa komplexa arbetsflöden direkt i terminalen.

    Smart kopiering till urklipp

    När man kopierar text från terminalen lägger Ghostty nu flera format i urklipp samtidigt.

    Förutom vanlig text inkluderas även HTML-format. Det innebär att färger och formatering kan bevaras när text klistras in i exempelvis dokument eller e-postklienter.

    Stora förbättringar i prestanda

    Utvecklarna har också arbetat mycket med prestanda. Genom att analysera omkring 4 GB terminalinspelningar från tjänsten asciinema kunde de optimera hur Ghostty hanterar terminaldata och rendering.

    Resultatet är:

    • snabbare uppspelning av terminalsessioner
    • mindre väntetid i renderingsmotorn
    • effektivare I/O-hantering

    Flera stabilitetsfixar

    Version 1.3 löser även ett långvarigt problem: en minnesläcka som funnits sedan Ghostty 1.0 har nu åtgärdats.

    Utvecklarna har dessutom använt omfattande fuzz-testning för att stress-testa terminalens parser för escape-sekvenser och VT-dataströmmar. Det gör programmet mer robust mot felaktig eller ovanlig terminaldata.

    Automatisering på macOS

    På macOS introducerar Ghostty stöd för AppleScript.

    Det gör det möjligt för externa skript och program att styra terminalen, till exempel:

    • skapa nya fönster
    • öppna flikar
    • dela upp terminalrutor
    • skicka kommandon

    Funktionen är aktiverad som standard men är fortfarande märkt som förhandsversion medan API:t stabiliseras.

    Notiser när kommandon är klara

    En annan praktisk nyhet är notiser när ett kommando är färdigt. Funktionen kan användas när man kör långvariga kommandon, exempelvis kompilering eller databearbetning.

    Ghostty kan då:

    • visa en skrivbordsnotis
    • spela ett terminal-ljud
    • eller båda

    Det går även att konfigurera så att notiser bara visas när terminalfönstret inte är i fokus.

    Sex månader av utveckling

    Ghostty 1.3 är resultatet av ungefär sex månaders arbete. Under den tiden har:

    • 180 utvecklare bidragit
    • över 2 858 kodändringar gjorts

    Utöver de större funktionerna innehåller versionen hundratals mindre förbättringar, buggrättningar och optimeringar.

    En terminal som fortsätter utvecklas snabbt

    Med funktioner som historiksökning, systemintegrerade scrollbars och bättre tangentbordsstöd tar Ghostty ännu ett steg mot att bli ett av de mest avancerade terminalprogrammen för både Linux och macOS.

    Utvecklingen går dessutom snabbt – något som tyder på att Ghostty kan bli en stark konkurrent till etablerade terminaler under de kommande åren.

    https://ghostty.org

    Fakta: Ghostty 1.3

    Ghostty 1.3 är en större uppdatering av den GPU-accelererade terminalemulatorn Ghostty.

    • Ny sökfunktion i terminalhistoriken
    • Systemanpassade scrollbars för macOS och GTK
    • Stöd för klickbar markörflytt i shell-prompt
    • Förbättrade tangentbordsgenvägar och nyckeltabeller
    • Smartare kopiering med stöd för både text och HTML
    • Prestandaförbättringar och minnesläckor åtgärdade
    • Notiser när långkörande kommandon avslutas
  • Rust 1.94 gör språket mer uttrycksfullt och kraftfullt

    Programmeringsspråket Rust fortsätter att utvecklas i snabb takt. Den nya versionen Rust 1.94 introducerar flera förbättringar som gör språket både mer ergonomiskt och mer kraftfullt. Bland nyheterna finns en ny iterator för slice-data, förbättrad konfigurationshantering i Cargo, stöd för den senaste versionen av TOML-formatet och flera stabiliserade API:er i standardbiblioteket.

    Tillsammans innebär förändringarna att utvecklare kan skriva mer tydlig kod, organisera projekt bättre och dra nytta av nya funktioner i både språket och verktygskedjan.

    Ny iterator för slices: array_windows

    En av de mest uppmärksammade nyheterna är metoden array_windows för slices. Den fungerar på liknande sätt som den befintliga metoden windows, men med en viktig skillnad: den returnerar arrayer med fast storlek i stället för dynamiska slices.

    Detta gör att kompilatorn kan veta storleken på varje fönster redan vid kompilering, vilket förenklar kod och kan ge bättre optimeringar.

    En praktisk användning är när man vill analysera mönster i en dataström. Ett klassiskt exempel är att leta efter så kallade ABBA-mönster, där två olika tecken följs av samma två tecken i omvänd ordning, exempelvis abba eller xyyx.

    Med array_windows kan en sådan kontroll skrivas mycket kompakt:

    Här kan kompilatorn automatiskt förstå att varje fönster ska bestå av fyra element eftersom de destruktureras till fyra variabler.

    Cargo får bättre stöd för modulär konfiguration

    Rusts byggverktyg Cargo får i version 1.94 en ny funktion: möjligheten att inkludera konfigurationsfiler i andra konfigurationsfiler.

    Detta gör att större projekt kan dela upp sin konfiguration i flera mindre filer, vilket gör dem enklare att underhålla och återanvända mellan olika projekt eller utvecklingsmiljöer.

    Ett exempel är:

    Det går även att ange mer avancerade alternativ via så kallade inline-tabeller, exempelvis om en konfigurationsfil är valfri:

    Detta gör det möjligt att skapa konfigurationer som fungerar både lokalt och i olika utvecklingsmiljöer utan att alla filer behöver finnas överallt.

    Stöd för TOML 1.1

    Cargo kan nu också läsa TOML 1.1, den senaste versionen av konfigurationsformatet som används i Rust-projekt.

    Bland förbättringarna i TOML 1.1 finns:

    • inline-tabeller som kan skrivas över flera rader
    • stöd för fler escape-sekvenser i strängar
    • möjlighet att utelämna sekunder i tidsangivelser
    • trailing commas i vissa strukturer

    Det innebär exempelvis att beroenden i Cargo.toml kan skrivas mer läsbart:

    Om man använder dessa nya funktioner höjs dock projektets MSRV (Minimum Supported Rust Version), eftersom äldre Cargo-versioner inte kan tolka den nya syntaxen. Samtidigt hanterar Cargo detta automatiskt vid publicering genom att skriva om manifestfiler så att de förblir kompatibla med äldre verktyg.

    Nya matematiska konstanter i standardbiblioteket

    Rusts standardbibliotek har också utökats med några klassiska matematiska konstanter. Bland de nya konstanterna finns:

    • Euler–Mascheroni-konstanten (EULER_GAMMA)
    • det gyllene snittet (GOLDEN_RATIO)

    De finns tillgängliga för både f32 och f64 och kan användas direkt i numeriska beräkningar utan att utvecklare behöver definiera dem själva.

    Fler stabiliserade API:er

    Som i varje Rust-release har även flera tidigare experimentella funktioner nu blivit stabila API:er. Bland dessa finns bland annat:

    • array_windows och element_offset för slices
    • nya metoder för LazyCell och LazyLock
    • nya metoder i iteratorn Peekable
    • hårdvaruintrinsics för AVX-512 FP16 på x86 och NEON FP16 på AArch64

    Dessutom kan vissa funktioner, som mul_add för flyttal, nu användas i konstanta uttryck.

    Fortsatt snabb utveckling av Rust

    Rust 1.94 visar tydligt hur språket fortsätter att utvecklas i både små och stora steg. Förbättringar som array_windows gör koden mer uttrycksfull, medan förändringar i Cargo och TOML gör projekthanteringen mer flexibel.

    Utvecklare som redan använder Rust kan uppdatera till den nya versionen med kommandot:

    Den nya versionen är resultatet av arbete från ett stort antal bidragsgivare i Rust-communityt – ett exempel på hur ett modernt open source-projekt fortsätter att förbättras genom globalt samarbete.

    C vs Rust

    C

    C är ett klassiskt programspråk som har använts i årtionden för operativsystem, drivrutiner, inbyggda system och annan prestandakritisk programvara.

    Språket ger programmeraren mycket direkt kontroll över minne och hårdvara, vilket gör det snabbt och flexibelt.

    Nackdelen är att C saknar inbyggt skydd mot många vanliga minnesfel, vilket kan leda till buggar, krascher och säkerhetsproblem.

    Rust

    Rust är ett modernare systemspråk som också fokuserar på hög prestanda, men samtidigt vill minska risken för minnesfel och osäker kod.

    Genom sitt ägarskapssystem och sina kompilatorkontroller kan Rust förhindra många problem redan innan programmet körs.

    Det gör språket särskilt intressant för säkerhetskritiska system, servrar, verktyg och ny systemprogrammering.

    https://blog.rust-lang.org/2026/03/05/Rust-1.94.0

    Teknisk fakta: Rust 1.94

    Version: Rust 1.94.0

    Typ av uppdatering: Stabil utgåva

    Viktig nyhet: array_windows för slices

    Ny Cargo-funktion: stöd för include i konfigurationsfiler

    Manifestformat: Cargo kan nu tolka TOML 1.1

    Nya matematiska konstanter: EULER_GAMMA och GOLDEN_RATIO

    Fler förbättringar: stabiliserade API:er i standardbiblioteket och fler funktioner tillgängliga i const-kontext

    Uppdateringskommando:

    rustup update stable
  • NotepadNext 0.13 – klassisk enkelhet med moderna förbättringar

    NotepadNext 0.13 tar ett tydligt kliv framåt genom att kombinera den klassiska enkelheten från Notepad++ med moderna funktioner för tryggare och smidigare arbete. Med autosparade sessioner, stöd för arbetsytor och flera efterfrågade förbättringar stärker uppdateringen editorns roll som ett lättviktigt men kraftfullt verktyg för både kod och textredigering.

    NotepadNext, en modern och plattformsoberoende nytolkning av Notepad++, har släppts i version 0.13. Fokus ligger på att förbättra arbetsflödet utan att göra programmet tyngre eller mer komplext. Resultatet är en uppdatering som främst riktar sig till användare som vill ha en snabb, pålitlig och okomplicerad kod- och textredigerare.

    Autosparade sessioner ökar tryggheten

    Den mest märkbara nyheten i version 0.13 är autosparade sessioner. Alla öppna filer sparas automatiskt var 60:e sekund. Vid en krasch, omstart eller oavsiktlig stängning kan arbetet återställas nästan exakt där det lämnades. Funktionen är särskilt värdefull vid längre redigeringspass eller när man arbetar med många filer samtidigt.

    Workspace-läge för arbete med hela mappar

    NotepadNext får nu ett workspace-läge som gör det möjligt att öppna en hel katalog som arbetsyta. Detta aktiveras via den nya kommandoradsflaggan --workspace. Funktionen förenklar hantering av projekt som består av flera filer och gör editorn mer användbar även utanför enstaka filredigering.

    Nya och förbättrade redigeringsfunktioner

    Uppdateringen innehåller flera förbättringar som ger användaren mer kontroll över gränssnitt och beteende. Det går nu att slå av och på radnummer, inaktivera automatisk URL-markering samt klicka direkt på EOL-indikatorn i statusfältet. En ny funktion gör det möjligt att ta bort dubbla rader, inklusive upprepade rader i följd. Markörens beteende har justerats för att bättre respektera markerade områden, och sökresultat använder nu en enhetlig typsnittsstorlek för bättre läsbarhet.

    Buggfixar och förbättrad stabilitet

    Version 0.13 åtgärdar flera praktiska problem som tidigare kunde störa arbetsflödet. Hanteringen av filsökvägar vid start av flera instanser har förbättrats, liksom dialogen för omladdning av ändrade filer. Det finns nu också stöd för att ange en standardkatalog vid filöppning. Session- och omladdningslogiken har finjusterats för att minska avbrott under längre arbetspass.

    Utökat språk- och syntaxstöd

    På syntaxsidan har stöd för Abaqus lagts till. Lokaliseringen har samtidigt utökats med nya översättningar till italienska och tyska, uppdateringar för brasiliansk portugisiska och ukrainska samt ett uppfräschat portugisiskt språkstöd.

    Tillgänglighet på Linux

    För Linuxanvändare finns NotepadNext tillgänglig både som Flatpak och som AppImage, vilket gör installationen enkel oavsett distribution.

    Sammanfattning

    NotepadNext 0.13 är en tydlig förbättring som bygger vidare på programmets grundidé: snabbhet, enkelhet och fokus på själva redigeringen. Med autosparade sessioner och workspace-stöd tar editorn ett steg framåt utan att förlora sin lättviktiga karaktär, vilket gör den till ett attraktivt alternativ för både vardagsanvändare och utvecklare.

    Så här installera du Notepadnext på ubuntu och debian.

    På Ubuntu och Debian kan NotepadNext installeras helt via terminalen med hjälp av Flatpak. Nedan är ett komplett exempel som visar varje steg i ordning.

    Först installerar du Flatpak om det inte redan finns på systemet:

    sudo apt update
    sudo apt install flatpak
    

    Därefter lägger du till Flathub, som är det officiella programförrådet där NotepadNext finns:

    sudo flatpak remote-add --if-not-exists flathub https://flathub.org/repo/flathub.flatpakrepo
    

    När Flathub är aktiverat kan du installera NotepadNext:

    flatpak install flathub com.github.dail8859.NotepadNext
    

    Efter installationen kan programmet startas direkt från terminalen:

    flatpak run com.github.dail8859.NotepadNext
    

    NotepadNext kommer nu även att synas i programmenyn tillsammans med övriga installerade program. Uppdateringar hanteras automatiskt via Flatpak, vilket gör att du alltid har tillgång till den senaste versionen utan extra arbete.

    Installation av NotepadNext på Ubuntu/Debian (Flatpak)
    1) Installera Flatpak
    sudo apt update
    sudo apt install flatpak
      
    2) Lägg till Flathub
    sudo flatpak remote-add --if-not-exists flathub https://flathub.org/repo/flathub.flatpakrepo
      
    3) Installera NotepadNext
    flatpak install flathub com.github.dail8859.NotepadNext
      
    4) Starta programmet
    flatpak run com.github.dail8859.NotepadNext
      
  • Micro 2.0.15 – terminalredigeraren som gör comeback

    Efter nästan ett års tystnad är den populära terminalbaserade textredigeraren Micro tillbaka med version 2.0.15. Uppdateringen fokuserar på förbättrad syntaxmarkering, stabilare redigering och ett mognare plugin-system, och markerar ett tydligt steg framåt för ett verktyg som vill kombinera enkelhet med kraften hos moderna kodredigerare – helt i terminalen.

    Efter en längre paus är den terminalbaserade textredigeraren Micro tillbaka med version 2.0.15. Det är den första nya utgåvan sedan version 2.0.14 från augusti 2024 och markerar ett tydligt steg framåt för projektet, både tekniskt och användarmässigt.

    Micro är utformad för att vara lätt att använda direkt, samtidigt som den erbjuder funktioner som annars ofta förknippas med fullskaliga grafiska textredigerare. Med intuitiva tangentkommandon, musstöd och modern funktionalitet har Micro blivit ett populärt alternativ för användare som vill arbeta effektivt i terminalen utan att behöva lära sig komplexa kommandospråk.

    Stora förbättringar i syntaxmarkering

    Den största nyheten i Micro 2.0.15 är de omfattande förbättringarna av syntaxmarkeringen. Stöd har utökats eller förfinats för många språk och filformat, bland annat Rust, Java, Swift, Haskell, OpenSCAD, Meson, PRQL, nftables, Fish shell, Groovy och Ruby. Även JavaScript-varianter som .cjs samt olika assembly- och C++-specialfall har fått bättre hantering.

    Utöver nya språk har flera problem från tidigare versioner rättats till, exempelvis felaktig tolkning av nyckelord, kommentarer och strängliteraler som uppstod efter tidigare ändringar i syntaxreglerna.

    Förbättrad redigering och navigering

    Även själva redigeringsfunktionerna har blivit mer konsekventa. Kommandon för att kopiera, klippa ut, ta bort och duplicera text fungerar nu bättre i alla situationer, inklusive specialfall som den sista raden i en fil.

    Navigeringen har också utvecklats. Nya funktioner för page up och page down beter sig nu mer som i nano, markören kan positioneras mer logiskt i förhållande till den synliga delen av dokumentet och arbetet med flera markörer samtidigt har förbättrats. Samtidigt har många regressioner åtgärdats, till exempel problem med scrollning, delade vyer, fönsterstorlekar och markörplacering.

    Stabilitet, säkerhet och plugins

    På stabilitetssidan har Micro blivit säkrare vid filhantering. Sparfunktionen är mer robust, onödiga säkerhetskopior skapas inte längre för oförändrade filer och sparning med förhöjda rättigheter fungerar bättre. Viktigt är också att risken för dataförlust har minskat vid arbete med delade buffertar.

    Plugin-systemet har utvecklats med nya callbacks och utökade API:er, samtidigt som gränsen mellan inbyggda och externa plugins blivit tydligare. För ökad säkerhet kan plugins inte längre ändra centrala konfigurationsfiler utan uttryckligt tillstånd från användaren.

    Byggstöd och framtid

    Slutligen har stödet för korskompilering förbättrats. Windows ARM64 stöds nu officiellt och alla byggen är helt statiska med CGO avstängt. Det gör Micro enklare att distribuera och mer pålitlig i olika miljöer.

    Snabba tangentkommandon i Micro

    KommandoFunktion
    Ctrl + SSpara fil
    Ctrl + QAvsluta Micro
    Ctrl + OÖppna fil
    Ctrl + FSök i dokument
    Ctrl + RSök och ersätt
    Ctrl + CKopiera
    Ctrl + XKlipp ut
    Ctrl + VKlistra in
    Ctrl + ZÅngra
    Ctrl + YGör om
    Ctrl + KKlipp ut aktuell rad
    Ctrl + DDuplicera rad eller markering
    Alt + ← / →Hoppa ordvis
    Ctrl + ← / →Byt flik
    Ctrl + \Dela vy
    Ctrl + WStäng aktuell vy
    Page Up / Page DownBläddra sida för sida

    Micro 2.0.15 visar tydligt att projektet är tillbaka på banan. Med förbättrad syntaxmarkering, stabilare beteende och ett mer moget plugin-system befäster Micro sin roll som ett modernt och lättillgängligt verktyg för effektiv textredigering i terminalen.

    Exempel på installation i praktiken

    På Ubuntu och Debian kan Micro installeras på flera sätt, och här är ett sammanhängande exempel som visar hur det går till i praktiken. Det vanligaste sättet är att använda den inbyggda pakethanteraren. Man börjar då med att uppdatera paketlistan och installerar sedan redigeraren direkt från programförråden genom att köra kommandona:

    sudo apt update
    sudo apt install micro
    

    Efter detta kan Micro startas genom att skriva micro följt av ett filnamn i terminalen.

    Vill man istället installera den senaste versionen från utvecklarna själva kan man använda Micros officiella installationsskript. Först laddas skriptet ner och görs körbart, därefter körs det för att hämta den färdiga binären:

    wget https://getmic.ro
    chmod +x getmic.ro
    ./getmic.ro
    sudo mv micro /usr/local/bin/
    

    När binären har flyttats till /usr/local/bin är Micro tillgänglig systemövergripande.

    Ett tredje alternativ är att använda Snap, vilket ger automatiska uppdateringar. Installationen görs då med ett enda kommando:

    sudo snap install micro --classic
    

    Samtliga metoder leder till samma resultat: Micro är installerat och redo att användas direkt i terminalen.

    https://github.com/zyedidia/micro/releases/tag/v2.0.15

    Faktaruta: Vad är nytt i Micro 2.0.15?
    • Större lyft för syntaxmarkering: Fler och bättre regler för många språk/format (t.ex. Rust, Java, Swift, Haskell, Ruby, Groovy, Fish, nftables, PRQL) samt fler JavaScript-varianter som .cjs.
    • Färre feltolkningar: Fixar för nyckelord, kommentarer och literaler som tidigare kunde ge fel färgsättning eller trasiga regler.
    • Mer konsekvent redigering: Åtgärdar specialfall för kopiera/klipp/ta bort/duplicera, bland annat problem runt sista raden i filer.
    • Smidigare navigering: Nya markör- och sidbläddringsbeteenden (inspirerat av nano), förbättrad markörplacering i synlig vy och bättre multicursor.
    • Stabilare scroll och vyer: Fixar regressioner kring scrollning, vyjustering, split-resize och markörplacering.
    • Säkrare sparning: Robustare skrivning, färre onödiga backups, förbättrad sparning med höjda rättigheter och skydd mot dataförlust vid delade buffertar.
    • Plugin-systemet stramas upp: Nya callbacks och utökade API:er, tydligare gräns mellan inbyggda och externa plugins – plus att plugins inte får ändra kärnkonfig utan tillstånd.
    • Bättre byggstöd: Förbättrad korskompilering (inkl. Windows ARM64) och byggen som är helt statiska med CGO avstängt.
  • Fish Shell 4.3 – när kommandoraden blir smartare, snyggare och mer förutsägbar

    Fish Shell 4.3 är en uppdatering som vid första anblick kan verka försiktig, men som i praktiken förändrar hur skalet upplevs i det dagliga arbetet. Istället för stora, uppseendeväckande nyheter har utvecklarna fokuserat på att göra befintliga funktioner tydligare, smartare och mer konsekventa. Resultatet är ett kommandoskal som känns mer förutsägbart, lättare att konfigurera och bättre anpassat till moderna terminaler. För både vana användare och nyfikna nybörjare markerar version 4.3 ett steg mot en mer genomtänkt och harmonisk terminalupplevelse.

    Kommandoraden är för många ett arbetsredskap snarare än ett användargränssnitt. Ändå är det just där som Fish Shell, Friendly Interactive SHell, skiljer sig från mängden. Med version 4.3 tar Fish ännu ett steg mot att göra terminalen både mer begriplig och mer intelligent, utan att tumma på kraften under huven.
    Den här versionen är inte en dramatisk omvälvning, utan snarare en noggrant avvägd evolution: bättre standardbeteenden, renare konfigurationer och en terminalupplevelse som anpassar sig efter användaren, inte tvärtom.

    Mindre magi, mer kontroll: nya konfigurationsprinciper

    En av de största förändringarna märks först knappt alls. Tidigare använde Fish så kallade universella variabler för färger, teman och tangentbindningar. De var praktiska men också svåröverskådliga.
    I Fish 4.3 ändras detta i grunden. Standardvariabler som fish_color_* och fish_key_bindings sätts nu globalt i stället för universellt. Vid första starten efter uppgradering gör Fish en engångsmigrering som fryser ditt nuvarande tema och dina tangentbindningar till filer i ~/.config/fish/conf.d/.
    Utvecklarna rekommenderar därefter att man tar bort dessa automatiskt skapade filer och istället hanterar allt direkt i config.fish. Resultatet blir en mer förutsägbar, lättläst och versionshanterbar konfiguration. Det går fortfarande att använda universella variabler, men då medvetet och med vetskapen om att de inte lämpar sig lika väl för dynamiska teman.

    Ett nytt språk – bokstavligen

    Fish 4.3 introducerar ett nytt kommando i skriptspråket: status language. Det kan låta trivialt, men det löser ett gammalt problem. Nu kan man se vilket språk Fish använder för sina meddelanden och ändra språket utan att behöva manipulera globala miljövariabler. Detta är särskilt användbart i skript, testmiljöer och dokumentation där man vill ha konsekventa och reproducerbara utdata.

    Smartare kompletteringar – även bakom kulisserna

    Fish är känt för sina intelligenta kompletteringar, och här har version 4.3 förfinat detaljerna. commandline –cursor fungerar nu korrekt även i icke-interaktiva sessioner. Kompletteringar hanterar sökvägar som innehåller = eller : betydligt bättre. Skiftlägesokänslig prefixmatchning gör att fler träffar hittas snabbare, och autosuggestioner kan nu radbrytas mjukt i stället för att kapas abrupt.
    För användare på Cygwin och MSYS har Fish dessutom blivit bättre på att matcha körbara filer mot rätt metadata, vilket ger mer konsekvent beteende över plattformar.

    Redigering med filsystemsförståelse

    Även tangentbordsarbetet har förbättrats. Ctrl-W tar nu bort escaped spaces när man raderar delar av en sökväg. Nya sökvägsmedvetna redigeringsfunktioner gör det enklare att navigera och justera långa filstigar direkt på kommandoraden. Det är små förbättringar som snabbt blir oumbärliga för den som arbetar mycket i terminalen.

    Teman som anpassar sig efter ljus och mörker

    En modern terminal växlar ofta mellan ljus och mörk bakgrund. Fish 4.3 möter detta genom att låta teman definiera separata sektioner för ljusa och mörka färgscheman. Flera av Fish standardteman har redan uppdaterats för detta. Resultatet är ett skal som ser rätt ut oavsett om du arbetar mitt i natten eller i fullt dagsljus.

    Djupare terminalintegration – utan att vara i vägen

    Fish fortsätter att förbättra sin integration med avancerade terminalfunktioner. OSC-signalerna för promptgränser är nu mer konsekventa, den aktuella arbetskatalogen rapporteras korrekt och fokusrapportering är aktiverad som standard. En ny funktionsflagga gör det dessutom möjligt att stänga av terminalsärlösningar när de inte behövs, vilket ger bättre kontroll i specialmiljöer.

    Stabilitet och puts: färre krascher, färre överraskningar

    Slutligen adresserar Fish 4.3 en rad regressionsproblem från tidigare versioner. Det gäller bland annat krascher kopplade till färgvariabler, problem med Unicode-autosuggestioner, emoji-bredd på macOS, kantfall vid flerradig inmatning och kompletteringsproblem på system utan glibc. Inget av detta är spektakulärt, men allt bidrar till ett skal som helt enkelt känns mer pålitligt.

    Sammanfattning

    Fish Shell 4.3 är ett tydligt exempel på mogen programutveckling. Fokus ligger inte på uppseendeväckande nyheter utan på tydligare konfiguration, bättre standardbeteenden, modern terminalanpassning och många små förbättringar som gör stor skillnad i vardagen. För den som lever i terminalen är detta en uppdatering som inte ropar, men som stillsamt visar att det bara fungerar.

    https://fishshell.com

    Faktaruta: Fish Shell 4.3

    Version: 4.3
    Typ: Interaktivt Unix-skal
    Mål: Förbättrad användarvänlighet utan att offra kraft

    Viktiga nyheter:
    – Standardvariabler för teman och tangentbindningar är nu globala istället för universella
    – Engångsmigrering fryser befintligt tema till conf.d-filer vid uppgradering
    – Nya kommandot status language styr språk för Fish-meddelanden
    – Förbättrade och mer träffsäkra kompletteringar, även i icke-interaktiva lägen
    – Teman kan reagera dynamiskt på ljusa och mörka terminaler
    – Fördjupad terminalintegration med tydligare promptgränser och fokusrapportering

    Plattformar: Linux, macOS, *BSD, Cygwin/MSYS
    Licens: GPLv2
    Webbplats: https://fishshell.com

Etikett: programmering

  • Pulsar 1.133 släppt – snabbare kodredigering och förbättrad terminal i Atoms efterföljare

    Den öppna källkodsredigeraren Pulsar har släppts i version 1.133. Uppdateringen innehåller en förbättrad terminal, snabbare hantering av stora filer och en omarbetad funktion för att övervaka filändringar. Samtidigt förbereder utvecklarna ett större teknikskifte som bland annat ska ge bättre stöd för Wayland på Linux. När GitHub lade ned utvecklingen av den populära kodredigeraren Atom i…

  • Moxnox 1.0 – ett nytt operativsystem som förenar Windows NT och Unix

    Vad händer om man tar några av de bästa idéerna från Windows NT, kombinerar dem med Unix och bygger ett helt nytt operativsystem från grunden? Det är precis vad utvecklaren Mark Harmstone har gjort. Resultatet heter Moxnox, och nu har version 1.0 släppts som öppen källkod. När man talar om operativsystem handlar diskussionen nästan alltid…

  • Lightpanda 1.0 är här – webbläsaren som inte behöver visa webbsidor

    En webbläsare som inte kan visa webbsidor på skärmen låter kanske som en ganska meningslös uppfinning. Men Lightpanda är byggd för en helt annan uppgift: att låta datorer och AI-system använda internet snabbt och resurssnålt. Nu har projektet nått version 1.0 och lämnat betastadiet efter två års utveckling. Den 2 oktober 2026 presenterades den första…

  • Linus Torvalds säger nej till AI-förbud i Linux – utvecklaren måste förstå sin kod

    Artificiell intelligens blir allt vanligare inom programmering, men hur ska man hantera kod som skrivits med hjälp av AI? Frågan har skapat en intensiv debatt bland utvecklarna av Linux. Nu tar Linux skapare Linus Torvalds tydligt ställning: Det viktiga är inte vilka verktyg programmeraren använder, utan att personen förstår och tar ansvar för resultatet. Linux…

  • Linus Torvalds testar AI-skriven Linuxkod – tredubblar läshastigheten

    Linux skapare Linus Torvalds har tagit hjälp av AI-verktyget Claude Code för att optimera Linuxkärnan. I ett experiment har han lyckats mer än tredubbla antalet läsoperationer per sekund genom att förändra hur operativsystemet hanterar arbetsminnet. Resultatet visar AI-teknikens möjligheter inom avancerad programmering, men väcker också frågor om tillförlitlighet och säkerhet. När processorkärnorna konkurrerar om minnet…

  • Hur skulle världen se ut utan öppen källkod?

    Föreställ dig att din mobiltelefon, din TV, din router och stora delar av internet plötsligt måste byggas om från grunden. Inte därför att tekniken har försvunnit, utan därför att ingen längre får dela med sig av programkod. Tänk dig att du var tvungen att åka tillbaka till 90-talet, där du bara kunde spela ”Snake” på…

  • Från hobbyprojekt till världens digitala ryggrad – Linux fyller 35 år

    Den 25 augusti 1991 berättade den då 21-årige studenten Linus Torvalds att han arbetade på ett fritt operativsystem. Projektet var enligt honom ”bara en hobby” och skulle inte bli särskilt stort. Trettiofem år senare finns Linux i allt från mobiltelefoner och trådlösa routrar till superdatorer, rymdsystem och världens största datacenter. När Linus Torvalds publicerade sitt…

  • GCC säger nej till betydande kod som skapats av AI

    Utvecklare får använda AI för att diskutera idéer, förstå källkod och göra efterforskningar. Men kod som helt eller delvis bygger på material från språkmodeller som ChatGPT, Gemini eller GitHub Copilot ska normalt inte tas emot som bidrag till GNU Compiler Collection. GCC Steering Committee, den grupp som leder utvecklingen av GNU Compiler Collection, har antagit…

  • GNU Binutils 2.47 gör utvecklarnas verktygslåda snabbare och mer flexibel

    GNU-projektet har släppt Binutils 2.47, en ny version av den viktiga verktygssamling som används för att bygga och analysera program i Linux. Uppdateringen ger bland annat bättre stöd för RISC-V, nya möjligheter vid felsökning och snabbare länkning av stora program. GNU-projektet har släppt GNU Binutils 2.47, en ny version av den verktygssamling som används för…

  • Codeberg säger nej till projekt som huvudsakligen skapats av AI

    Den ideella kodplattformen Codeberg förbjuder nu projekt som till största delen består av AI-genererad kod. Beslutet grundas på osäker upphovsrätt, säkerhetsrisker och svårigheten att avgöra vem som egentligen ansvarar för programvaran. Den ideella kodplattformen Codeberg inför nya regler för programvara som har skapats med hjälp av generativ artificiell intelligens. Projekt där merparten av källkoden har…

  • Perl 5.44 släppt – får namngivna parametrar, bättre prestanda och Unicode 17

    Perl 5.44 har släppts med experimentellt stöd för namngivna parametrar, förbättrad prestanda och stöd för Unicode 17. Den nya versionen innehåller även flera säkerhetsrättningar, strängare regler för Unicode-tecken och uppdateringar av språkets reguljära uttryck. Programmeringsspråket Perl har fått en ny stabil version. Perl 5.44 innehåller bland annat experimentellt stöd för namngivna parametrar, bättre Unicode-hantering, flera…

  • Linus Torvalds: Från programmerare till utvecklingsledare

    Linus Torvalds skriver numera sällan kod själv och beskriver sin roll som utvecklingsledare. Under Open Source Summit India 2026 berättade han om arbetet bakom Linuxkärnan, synen på AI och Rust samt varför föråldrad teknik ibland måste tas bort. Linus Torvalds skriver numera sällan kod själv. I stället leder han utvecklingen av Linuxkärnan genom att granska…

  • När Linux sätter gränser för vad som är en säkerhetsbugg

    När antalet AI-genererade sårbarhetsrapporter ökar vill Linuxprojektet dra en tydligare gräns mellan vanliga buggar och verkliga säkerhetshål. Linus Torvalds har nu slagit ihop ny dokumentation som förklarar när ett fel i Linuxkärnan ska behandlas som en säkerhetsbugg, hur rapporter bör skickas in och varför spekulativa AI-fynd inte får belasta säkerhetsteamet i onödan. Resultatet är en…

  • GCC 16.1 är här – och C++ tar ett stort kliv in i 2020-talet

    GCC 16.1 är här och markerar början på en ny fas för GNU Compiler Collection. Med C++20 som nytt standardläge, experimentellt stöd för kommande C++26-funktioner och förbättringar för både diagnostik, optimering och modern hårdvara är detta en release som kan få stor betydelse för utvecklare. Samtidigt kan äldre kodbaser behöva ses över när kompilatorn tar…

  • Rust 1.95 släppt – större lyft för matchning, villkorsstyrd kod och standardbiblioteket

    Rust 1.95 är här med stöd för if let-guards i match, det nya makrot cfg_select! och en lång rad nya stabila API:er i standardbiblioteket. Releasen innebär också förändringar för custom targets och ytterligare uppdateringar i Cargo och Clippy. Rust 1.95 har nu släppts och bjuder på flera nyheter för utvecklare, bland annat förbättrad mönstermatchning, ett…

  • Ghostty 1.3 – snabb terminalemulator får stora nyheter

    Ghostty 1.3 är här med flera av de funktioner som användarna länge har efterfrågat. Den GPU-accelererade terminalemulatorn får nu bland annat sökning i terminalhistoriken, inbyggda systemanpassade scrollbars, bättre tangentbordsstyrning och smartare notiser, samtidigt som utvecklarna har förbättrat både prestanda och stabilitet. Terminalprogram är ett av de viktigaste verktygen i Linux- och utvecklarvärlden. Nu har den…

  • Rust 1.94 gör språket mer uttrycksfullt och kraftfullt

    Programmeringsspråket Rust fortsätter att utvecklas i snabb takt. Den nya versionen Rust 1.94 introducerar flera förbättringar som gör språket både mer ergonomiskt och mer kraftfullt. Bland nyheterna finns en ny iterator för slice-data, förbättrad konfigurationshantering i Cargo, stöd för den senaste versionen av TOML-formatet och flera stabiliserade API:er i standardbiblioteket. Tillsammans innebär förändringarna att utvecklare…

  • NotepadNext 0.13 – klassisk enkelhet med moderna förbättringar

    NotepadNext 0.13 tar ett tydligt kliv framåt genom att kombinera den klassiska enkelheten från Notepad++ med moderna funktioner för tryggare och smidigare arbete. Med autosparade sessioner, stöd för arbetsytor och flera efterfrågade förbättringar stärker uppdateringen editorns roll som ett lättviktigt men kraftfullt verktyg för både kod och textredigering. NotepadNext, en modern och plattformsoberoende nytolkning av…

  • Micro 2.0.15 – terminalredigeraren som gör comeback

    Efter nästan ett års tystnad är den populära terminalbaserade textredigeraren Micro tillbaka med version 2.0.15. Uppdateringen fokuserar på förbättrad syntaxmarkering, stabilare redigering och ett mognare plugin-system, och markerar ett tydligt steg framåt för ett verktyg som vill kombinera enkelhet med kraften hos moderna kodredigerare – helt i terminalen. Efter en längre paus är den terminalbaserade…

  • Fish Shell 4.3 – när kommandoraden blir smartare, snyggare och mer förutsägbar

    Fish Shell 4.3 är en uppdatering som vid första anblick kan verka försiktig, men som i praktiken förändrar hur skalet upplevs i det dagliga arbetet. Istället för stora, uppseendeväckande nyheter har utvecklarna fokuserat på att göra befintliga funktioner tydligare, smartare och mer konsekventa. Resultatet är ett kommandoskal som känns mer förutsägbart, lättare att konfigurera och…