• HWall – ny Linux-app vill ge full koll på datorns hårdvara

    Hur varm är processorn egentligen? Hur snabbt arbetar kärnorna, vad gör grafikkortet och börjar hårddisken visa tecken på problem? Det nya Linux-programmet HWall samlar både hårdvaruinformation och sensordata i ett och samma verktyg – och kan dessutom varna när något börjar bli för varmt eller belastat.
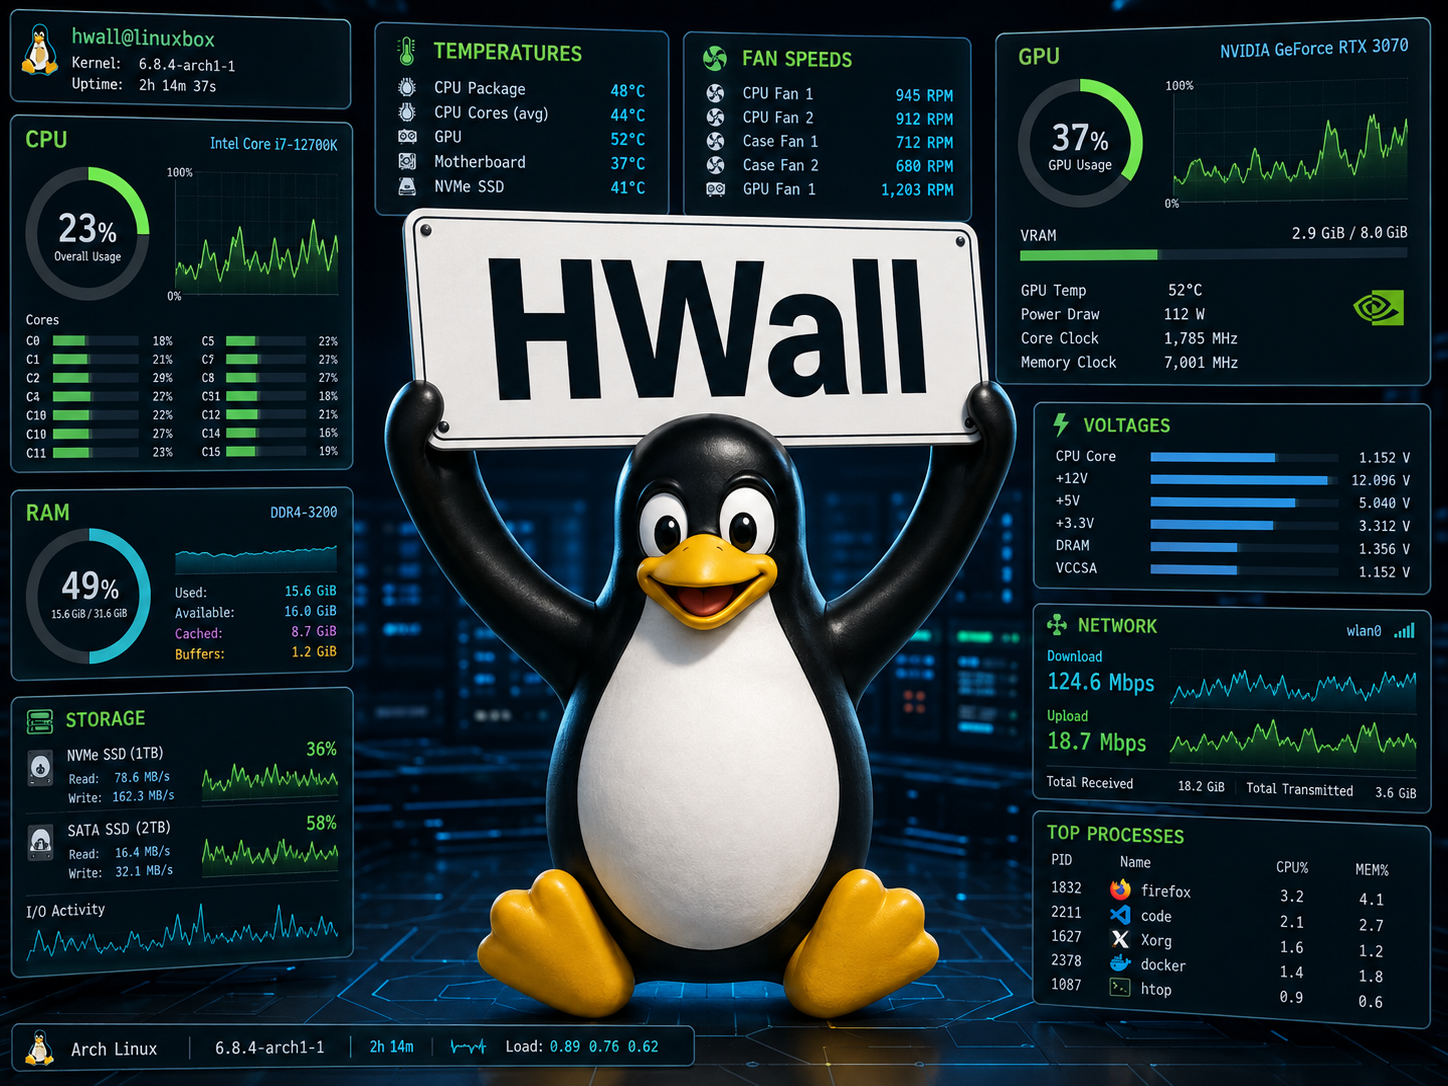
    Linux har länge haft mängder av verktyg för den som vill hålla ett öga på datorns hälsa. Program som visar processorbelastning, minnesanvändning och temperaturer är inget nytt. Däremot är det betydligt ovanligare med ett enda program som både kan beskriva vilken hårdvara datorn innehåller och samtidigt följa sensorer i realtid.

    Det är precis vad det nya open source-projektet HWall försöker göra.

    Programmet är skrivet i programmeringsspråket Rust och utvecklat specifikt för Linux. Tanken är att ge användaren en samlad bild av datorns komponenter, temperaturer, fläktar, lagringsenheter, nätverk och andra mätvärden.

    HWall finns både med ett grafiskt gränssnitt byggt med GTK 4 och som ett interaktivt terminalprogram.

    Inspirerat av HWiNFO för Windows

    Utvecklaren bakom HWall uppger att sättet att organisera sensorer i en hierarkisk struktur är inspirerat av HWiNFO64, ett populärt program för hårdvaruinformation och diagnostik under Windows.

    Ambitionen verkar alltså vara större än att bara visa några grafer över processor- och minnesanvändning.

    HWall försöker istället samla information från flera delar av Linux-systemet, bland annat Linux-kärnan, datorns firmware, installerade hårdvarudrivrutiner och vissa externa verktyg.

    Resultatet kan bli en ganska detaljerad bild av vad som faktiskt händer inne i datorn.

    Temperaturer, fläktar och spänningar

    Beroende på vilken hårdvara datorn har kan HWall bland annat visa:

    • processortemperaturer
    • temperaturer på moderkortet
    • fläkthastigheter
    • elektriska spänningar
    • processorbelastning
    • klockfrekvenser
    • aktivitet på lagringsenheter
    • nätverkstrafik
    • effekt- och energivärden

    Programmet håller dessutom reda på mer än bara det aktuella värdet.

    För varje sensor kan HWall registrera nuvarande, lägsta, högsta och genomsnittliga värde, tillsammans med hur många mätningar som har genomförts.

    Det gör det exempelvis möjligt att se att processorn för tillfället håller 55 grader, men tidigare under dagen varit uppe i 87 grader.

    HWall skiljer också mellan sensorer som är aktuella, inaktuella, otillgängliga eller helt offline. Det är viktigt eftersom ett värde som visas på skärmen annars skulle kunna misstolkas som en färsk mätning trots att sensorn slutat rapportera.

    Mäter hur snabbt processorn faktiskt arbetar

    En särskilt intressant funktion finns på vissa x86-baserade datorer.

    Moderna processorer ändrar hela tiden sin arbetshastighet beroende på belastning, temperatur och energisparfunktioner. Den frekvens som operativsystemet begär behöver därför inte alltid motsvara den frekvens som processorn faktiskt har arbetat med.

    HWall kan på kompatibla system använda processorernas så kallade APERF- och MPERF-räknare för att uppskatta den effektiva frekvensen.

    Det går både att visa ett genomsnitt och separata värden för varje logisk processor.

    Det kan ge en mer realistisk bild av hur processorn verkligen arbetar än att enbart läsa den rapporterade klockfrekvensen.

    Historik istället för bara ögonblicksbilder

    En temperaturmätning säger egentligen ganska lite om man bara ser värdet just nu.

    Är 80 grader normalt? Har temperaturen precis stigit? Har den legat där i flera timmar?

    Därför lagrar HWall också historiska sensordata i minnet.

    Standardinställningen är endast en minuts historik, men lagringen kan konfigureras för betydligt längre perioder – upp till 24 timmar.

    Historiken kan visas som interaktiva diagram där användaren bland annat kan zooma, panorera, undersöka tidpunkter och välja specifika tidsperioder.

    Det gör funktionen användbar vid exempelvis felsökning.

    Om en dator plötsligt börjar gå långsamt kan man i efterhand undersöka om processortemperaturen steg kraftigt, om belastningen låg på 100 procent eller om någon annan sensor förändrades samtidigt.

    Historiken kan även exporteras som CSV eller JSON Lines för vidare analys i andra program.

    En mycket kort mätintervall kombinerad med lång historik innebär förstås att programmet måste lagra och bearbeta betydligt fler datapunkter, vilket i sin tur ökar användningen av processor och arbetsminne.

    Kan varna innan problemen blir allvarliga

    HWall kan också användas som ett enklare övervakningssystem.

    För enskilda sensorer går det att sätta gränsvärden för när en varning eller ett kritiskt larm ska utlösas.

    Det behöver inte innebära att ett larm aktiveras så fort processorn råkar passera exempelvis 90 grader under några sekunder.

    Programmet har inställningar för bland annat varaktighet, hysteresis och cooldown.

    Det innebär förenklat att ett värde kan behöva ligga över en viss gräns under en bestämd tid innan larmet aktiveras. På så sätt minskar risken för onödiga varningar vid korta temperatur- eller belastningstoppar.

    När villkoren uppfylls kan HWall skicka en skrivbordsnotifikation.

    Kartlägger datorns komponenter

    HWall är samtidigt mer än ett sensorprogram.

    Det kan skapa ett hårdvaruregister som bland annat omfattar:

    • processor
    • arbetsminne
    • grafikkort
    • lagringsenheter
    • nätverkskort
    • USB-enheter
    • PCI-enheter
    • batterier
    • firmware
    • vissa säkerhetsenheter

    Med hjälp av externa verktyg kan ännu mer information hämtas.

    SMART- och NVMe-data kan exempelvis ge information om SSD- och hårddiskars hälsa, varningsindikatorer och olika livstidsvärden.

    Datorer med Nvidias proprietära Linux-drivrutin kan lämna ytterligare grafikkortsinformation via verktyget nvidia-smi.

    HWall kan också använda dmidecode för att få fram mer information om bland annat moderkort, BIOS eller UEFI, processorsocklar, TPM och installerade minnesmoduler.

    Vissa sådana uppgifter kan dock kräva högre behörighet i Linux.

    Linux-kärnan avgör vad som går att läsa

    Hur mycket information HWall faktiskt kan visa beror i hög grad på datorns hårdvara och Linux-stöd.

    För många temperatur-, fläkt- och spänningssensorer använder Linux systemet hwmon. Sensorerna blir normalt tillgängliga genom filer under:

    /sys/class/hwmon

    HWall läser den information som Linux redan tillhandahåller där.

    Programmet försöker däremot inte själv ladda sensordrivrutiner och kräver inte administratörsbehörighet för normal övervakning.

    Det betyder att två datorer med HWall kan visa helt olika mängder information.

    Resultatet beror bland annat på vilket moderkort som används, vilket sensorchip som sitter på kortet, vilken Linux-kärna som körs och om det finns en fungerande drivrutin.

    Exempel på kärnmoduler som kan göra moderkortssensorer tillgängliga är nct6775, it87, asus-ec-sensors, asus_wmi_sensors, w83627ehf och f71882fg.

    Om Linux inte kan läsa sensorn kan inte heller HWall trolla fram informationen.

    HWall ändrar inte datorns hårdvara

    En viktig detalj är att HWall är konstruerat som ett skrivskyddat övervakningsverktyg.

    Programmet försöker inte förändra datorns inställningar.

    Det styr alltså inte fläktarna, ändrar inte processorernas klockfrekvenser och justerar inte elektriska spänningar.

    HWall koncentrerar sig istället på att identifiera, läsa och presentera den information som Linux och de externa hjälpverktygen redan kan tillhandahålla.

    Det minskar också risken för att ett övervakningsprogram av misstag ändrar en känslig hårdvaruinställning.

    Fungerar även helt i terminalen

    För servrar och användare som föredrar kommandoraden finns också en terminalversion.

    Den kan skapa vanliga läsbara rapporter, filtrera sensorer efter kategori, exportera information som JSON och kontinuerligt skicka sensordata som JSON Lines.

    Det gör HWall potentiellt användbart även i automatiserade system.

    Ett skript skulle exempelvis kunna läsa temperaturer från HWall och sedan lagra dem i en databas eller skicka dem vidare till ett separat övervakningssystem.

    Terminalgränssnittet har dessutom flera interaktiva vyer, där användaren kan växla mellan hårdvaruinformation, sensorer eller en kombination av båda.

    Har ett litet HTTP-API

    En annan intressant möjlighet är HWall:s inbyggda HTTP-baserade JSON-API.

    Genom CLI-kommandot serve kan programmet tillhandahålla exempelvis aktuella sensormätningar, en sammanställning av systemstatus eller datorns hårdvaruinventering via nätverket.

    Servern kan bindas till en konfigurerbar lokal adress.

    Det öppnar för flera användningsområden.

    En Linux-dator skulle exempelvis kunna köra HWall i bakgrunden medan temperaturer och annan information visas på en separat dator, en webbpanel eller någon typ av lokal övervakningsskärm.

    Fortfarande ett mycket ungt projekt

    HWall befinner sig fortfarande i ett tidigt utvecklingsskede.

    Det innebär att man inte bör förvänta sig samma mognad som hos verktyg som utvecklats under många år.

    Vilken information som kan visas kommer dessutom alltid att begränsas av datorns firmware, Linux-kärnan, drivrutiner, behörigheter och vilka externa program som är installerade.

    Utvecklaren rekommenderar också försiktighet med att köra flera lågnivåprogram för hårdvaruövervakning samtidigt.

    Anledningen är att vissa drivrutiner kan behöva kommunicera med datorns firmware eller embedded controller varje gång ett sensorvärde läses. Om flera program gör sådana förfrågningar mycket ofta kan det i vissa system skapa problem.

    Måste än så länge kompileras från källkod

    HWall är ännu inte ett program som de flesta användare bara kan installera från distributionens vanliga paketförråd.

    I nuläget finns inga färdiga officiella binärpaket eller distributionspaket.

    Den som vill prova programmet behöver istället bygga det från källkoden.

    Bland kraven finns Rust 1.92 eller senare, utvecklingsfiler för GTK 4.8, pkg-config och en vanlig C-kompilatormiljö.

    Det placerar HWall i kategorin spännande projekt för Linux-entusiaster snarare än ett färdigt verktyg för den breda massan.

    Men idén är intressant.

    Linux har redan i dag nästan all information som behövs för avancerad hårdvaruövervakning. Problemet är ofta att informationen är utspridd mellan /sys, olika kommandoradsverktyg och separata grafiska program.

    Om HWall lyckas samla dessa delar i ett stabilt och lättanvänt gränssnitt kan projektet på sikt bli ett intressant Linux-alternativ för användare som vill ha ungefär samma typ av detaljerade hårdvaruöverblick som program som HWiNFO erbjuder under Windows.

    https://github.com/pulpul-s/HWall

    > TEKNISK FAKTA: HWall
    Program: HWall
    Plattform: Linux
    Licens: Open source
    Programmeringsspråk: Rust
    Grafiskt gränssnitt: GTK 4
    Terminalgränssnitt: Ja, interaktivt TUI/CLI
    Sensordata: Temperaturer, fläktar, spänningar, belastning, klockfrekvenser, lagring, nätverk och effekt
    Linux hwmon: /sys/class/hwmon
    Sensorstatistik: Aktuellt, minimum, maximum och medelvärde
    Historik: Upp till 24 timmar
    Export: CSV, JSON och JSON Lines
    Larm: Varnings- och kritiska gränsvärden med duration, hysteresis och cooldown
    Lagringshälsa: SMART- och NVMe-information
    NVIDIA: Extra GPU-data via nvidia-smi
    DMI-information: Kan kompletteras via dmidecode
    CPU-mätning: Stöd för APERF/MPERF på kompatibla x86-system
    API: HTTP-baserat JSON-API
    Hårdvarustyrning: Nej – HWall arbetar i read-only-läge
    Byggkrav: Rust 1.92+, GTK 4.8, pkg-config och C-kompilator
    $ HWall är fortfarande under tidig utveckling och hårdvarustödet beror på Linux-kärnan, drivrutiner, firmware och tillgängliga sensorer.
  • TrueNAS 25.10 “Goldeye” – framtidens öppna lagringssystem

    TrueNAS 25.10 “Goldeye” markerar ett stort steg framåt för öppen lagringsteknik. Den nya versionen introducerar stöd för NVMe over Fabric, öppna GPU-drivrutiner, förbättrad virtualisering och en moderniserad hantering av OpenZFS. Resultatet är en kraftfull och framtidssäker NAS-plattform som kombinerar prestanda i företagsklass med öppen källkod och flexibilitet – redo för allt från hemmalabb till datacenter.

    Den öppna lagringsplattformen TrueNAS har nått en ny milstolpe. Version 25.10 “Goldeye” markerar en av de största uppdateringarna på flera år, med stöd för NVMe över nätverk (NVMe-oF), öppna GPU-drivrutiner, omfattande ZFS-förbättringar och ett omdesignat administrationsgränssnitt.
    Resultatet är ett NAS-system som är snabbare, stabilare och bättre anpassat för moderna arbetslaster.

    En ny nivå av prestanda

    Den mest uppseendeväckande nyheten i TrueNAS 25.10 är stödet för NVMe over Fabric (NVMe-oF) – en teknik som gör att data på fjärransluten lagring kan nås lika snabbt som om den vore lokal.

    Två varianter erbjuds:

    • NVMe/TCP, som fungerar över vanliga Ethernet-nätverk och finns i Community Edition.
    • NVMe/RDMA, som används i Enterprise-versionen och ger extremt låg latens genom direkt minne-till-minne-kommunikation.

    Tillsammans möjliggör dessa lösningar terabitklassad nätverksprestanda och stöd för 400 Gbit/s Ethernet. I tester har ett TrueNAS-system levererat över 75 GB/s i läshastighet. Det gör NVMe-oF särskilt attraktivt för AI-träning, databaser och virtualiseringsmiljöer där varje millisekund räknas.

    Förbättrad virtualisering och säkerhet

    TrueNAS har länge erbjudit lätt virtualisering, men i version 25.10 har funktionen fått en kraftig uppgradering.
    Den nya Data Hypervisor-tekniken skiljer på virtuella maskiner och containerbaserade arbetslaster, vilket ger en tydligare och mer stabil användarupplevelse.

    Nyheter inkluderar:

    • Secure Boot för virtuella maskiner.
    • Import/export av virtuella diskar i flera format (QCOW2, RAW, VDI, VHDX, VMDK).
    • Hög tillgänglighet (HA) som gör det möjligt för virtuella maskiner att automatiskt flyttas vid nodfel.

    Detta ger TrueNAS Enterprise en mer komplett och driftsäker virtualiseringsmiljö med minimal nedtid.

    Öppen GPU-acceleration

    TrueNAS 25.10 stöder nu NVIDIAs öppna GPU-drivrutiner, vilket gör det möjligt att använda moderna grafikkort för beräkningar, AI och mediahantering.
    Stödet omfattar även NVIDIAs Blackwell-arkitektur, vilket öppnar för GPU-accelererade arbetsflöden direkt på TrueNAS-plattformen.

    Förbättrat ZFS och lagringshantering

    Filsystemet OpenZFS 2.3.4 ligger till grund för TrueNAS 25.10 och har fått flera viktiga förbättringar:

    • Bättre hantering av krypterad replikering.
    • Förbättrad minneshantering som minskar risken för krascher.
    • Stöd för Direct I/O, vilket ger snabbare prestanda i virtualiserade miljöer.
    • Effektivare blockkloning och mer informativ cache-rapportering.
    • Optimerad datafördelning som ger jämnare skrivprestanda under belastning.

    Tillsammans gör dessa ändringar ZFS ännu mer robust och förutsägbart vid hög I/O-belastning.

    Nytt gränssnitt och förbättrad användarupplevelse

    Administrationsgränssnittet i TrueNAS 25.10 har genomgått en omfattande uppdatering. Sidor för uppdateringar, användare, dataset och lagring har fått tydligare struktur och modernare design.

    En ny funktion, Update Profiles, låter användaren välja hur snabbt systemet ska ta emot uppdateringar:

    • Early Adopter – för den som vill testa nyheter tidigt.
    • General – standardläge med fokus på stabilitet.
    • Mission Critical – för miljöer med höga krav på drifttid.
    • Developer – för utvecklare och testmiljöer.

    Det nya systemet gör uppdateringsprocessen mer transparent och kontrollerad.

    Förbättrad apphantering

    TrueNAS 25.10 hanterar nu applikationer smidigare. Befintliga appar migreras automatiskt vid byte av applikationspool, vilket minskar nedtid.
    Det går även att konfigurera egna containerregistry-mirrors, vilket gör att applikationer fortsätter fungera även om Docker Hub inte är tillgänglig.

    Modern övervakning och öppet API

    Systemets diskövervakning har byggts om för att använda cron-baserad schemaläggning, vilket ger större flexibilitet och stöd för externa verktyg som Scrutiny.

    Dessutom introduceras en versionerad API byggd på JSON-RPC 2.0 över WebSocket. Den ersätter den äldre REST-baserade API:n och erbjuder snabbare svarstider och bättre stabilitet.
    API:n dokumenteras öppet på api.truenas.com och stöds redan av integrationer med Kubernetes, Proxmox VE och VMware vSphere.

    TrueNAS Connect – central fjärrhantering

    TrueNAS 25.10 är förberett för TrueNAS Connect, ett nytt webbaserat system för central hantering av flera TrueNAS-installationer.
    Plattformen ger realtidsövervakning, anpassningsbara varningar och inventariehantering via en säker molnportal.

    Community-användare kan testa TrueNAS Connect kostnadsfritt fram till december 2025.
    En bred lansering till Enterprise-kunder är planerad till våren 2026.

    Högre kapacitet och snabbare nätverk

    TrueNAS 25.10 utökar hårdvarustödet för större system.

    • F-serien stöder upp till 20 petabyte NVMe-flash.
    • M-serien kan hantera upp till 40 petabyte arkivlagring.
      Med stöd för 400 GbE-adaptrar är plattformen redo för nästa generation av datacenter.

    Sammanfattning

    TrueNAS 25.10 “Goldeye” representerar ett stort steg framåt för öppen lagringsteknik.
    Med stöd för NVMe-oF, öppna GPU-drivrutiner, förbättrad ZFS-prestanda, modernare virtualisering och ett tydligare gränssnitt fortsätter TrueNAS att befästa sin position som en av de mest avancerade och flexibla lagringsplattformarna med öppen källkod.

    TrueNAS Community Edition kan laddas ner kostnadsfritt för den som vill prova själv.
    För företag finns Enterprise-versionen, redan i bruk hos över 60 procent av Fortune 500-företagen.

    Mer information finns på https://www.truenas.com.

    TrueNAS 25.10 “Goldeye” — Fakta och teknisk data

    Utgivning: Oktober 2025
    Utvecklare: iXsystems
    Typ: Öppen källkod NAS / SAN / Hyperkonvergerad lagring
    Bas: Linux (TrueNAS SCALE)

    Filsystem: OpenZFS 2.3.4
    Förbättrad prestanda, Direct I/O-stöd, effektivare minneshantering och krypterad replikering.
    NVMe over Fabrics:
    • NVMe/TCP (TrueNAS Community Edition)
    • NVMe/RDMA (TrueNAS Enterprise Edition)
    Stöd för upp till 400 GbE, terabitklassad prestanda och extremt låg latens.
    Virtualisering:
    KVM-baserad ”Data Hypervisor”
    Stöd för Secure Boot, import/export av diskformat (QCOW2, RAW, VDI, VHDX, VMDK)
    Hög tillgänglighet (HA) med automatisk VM-failover.
    GPU-stöd:
    Inbyggt stöd för NVIDIAs öppna GPU-drivrutiner, inklusive Blackwell-generationen.
    Möjliggör GPU-accelererade AI-, media- och beräkningsarbetslaster.
    Systemhantering:
    Nydesignade paneler för användare, dataset, uppdateringar och lagring.
    Nya ”Update Profiles”: Early Adopter, General, Mission Critical och Developer.
    Appar migrerar automatiskt mellan pooler. Stöd för externa container registry-spegelservrar.
    Övervakning:
    SMART-övervakning ersatt av cron-baserad modell för bättre flexibilitet.
    Kompatibel med externa verktyg som Scrutiny.
    API och integration:
    Ny versionerad TrueNAS API (JSON-RPC 2.0 över WebSocket).
    Betydligt snabbare än tidigare REST-API och kompatibel med Kubernetes, Proxmox VE och VMware vSphere.
    Dokumentation: api.truenas.com
    TrueNAS Connect:
    Central webbaserad kontrollpanel för flera system.
    Ger realtidsövervakning, varningar och enkel installation.
    Gratis för Community-användare fram till december 2025.
    Kapacitet och hårdvara:
    • F-serien: upp till 20 PB NVMe-flash
    • M-serien: upp till 40 PB arkivlagring
    Stöd för Terabit Ethernet (400 GbE).
    Licensinformation:
    • Linux-kärna – GPLv2
    • Middleware & GUI – BSD-3-Clause
    • OpenZFS – CDDL
    Vissa Enterprise-komponenter omfattas av iXsystems-villkor.
    Fullständig EULA: TrueNAS SCALE EULA
    Kända begränsningar:
    NVMe/TCP-target saknar “fused commands” som krävs för VMware ESXi (upstream-begränsning).
    Mer information:
    Dokumentation: TrueNAS 25.10 Docs
    Releaseblogg: TrueNAS 25.10 “Goldeye” Release
  • Så kollar du hur hårddisken mår i Linux.

    SMART (Self-Monitoring, Analysis and Reporting Technology) är en inbyggd funktion i hårddiskar och SSD-enheter som kontinuerligt övervakar deras hälsa. Genom att analysera parametrar som temperatur, driftstimmar och antal defekta sektorer kan SMART ge tidiga varningssignaler om en enhet håller på att gå sönder. I Linux kan man med hjälp av paketet smartmontools snabbt kontrollera diskens status, köra självtester och sätta upp automatiserad övervakning. Denna artikel förklarar tekniken bakom SMART och visar hur du i praktiken kan kontrollera hårddiskars och SSD:ers hälsa i olika Linux-distributioner.

    Vad är SMART?

    SMART står för Self-Monitoring, Analysis and Reporting Technology. Det är en standardiserad teknik som finns inbyggd i nästan alla hårddiskar (HDD) och SSD-enheter.

    Syftet är att övervaka diskens hälsa i realtid och varna innan fel leder till dataförlust. SMART gör detta genom att logga olika attribut (mätvärden) som visar hur disken mår.

    Exempel på viktiga attribut:

    • Reallocated Sector Count – Antal sektorer som markerats defekta och ersatts med reservsektorer. Ett ökande värde betyder att disken försämras.
    • Current Pending Sector Count – Antal sektorer som är osäkra och väntar på omallokering. En stark varningssignal.
    • Power-On Hours – Hur länge enheten har varit igång. Ger en bild av diskens ålder.
    • Temperature – Diskens arbetstemperatur. Hög temperatur förkortar livslängden.
    • Wear Leveling Count (SSD) – Mäter hur mycket av flashminnets livslängd som har förbrukats.

    SMART fungerar genom att disken själv registrerar dessa värden och rapporterar dem till operativsystemet via ATA/SATA eller NVMe-protokoll. Systemadministratören kan sedan läsa ut informationen med verktyg som smartctl.

    Praktisk guide: Kontrollera diskar med SMART i Linux

    1. Installera verktyget smartmontools

    Debian/Ubuntu

    sudo apt update
    sudo apt install smartmontools

    Red Hat / CentOS / Fedora

    sudo dnf install smartmontools

    (äldre system:)

    sudo yum install smartmontools

    Arch Linux / Manjaro

    sudo pacman -S smartmontools

    openSUSE

    sudo zypper install smartmontools

    2. Identifiera disken

    Lista anslutna enheter:

    lsblk

    eller

    sudo fdisk -l

    Notera diskens beteckning, t.ex. /dev/sda, /dev/sdb, eller /dev/nvme0n1.


    3. Kontrollera SMART-stöd och status

    Visa information om enheten

    sudo smartctl -i /dev/sdX

    Snabb hälsokontroll

    sudo smartctl -H /dev/sdX
    • PASSED → Disken rapporterar inga kritiska fel.
    • FAILED → Disken är defekt, byt ut den.

    4. Läs ut detaljerad SMART-data

    sudo smartctl -A /dev/sdX

    Här får du fram attribut som:

    • Antal driftstimmar
    • Temperatur
    • Omallokerade sektorer
    • Pending-sektorer
    • SSD-slitagevärden

    5. Kör SMART-självtester

    SMART kan själv testa diskens hälsa genom interna tester.

    Kort test (ca 2 minuter):

    sudo smartctl -t short /dev/sdX

    Se resultatet:

    sudo smartctl -l selftest /dev/sdX

    Långt test (kan ta flera timmar):

    sudo smartctl -t long /dev/sdX

    Se resultatet:

    sudo smartctl -l selftest /dev/sdX

    6. Tolkning av resultat

    • Reallocated_Sector_Ct > 0 → Dålig disk, byt ut så snart som möjligt.
    • Current_Pending_Sector > 0 → Risk för dataförlust, byt disk.
    • Temperature > 55°C → För hög, kontrollera kylning.
    • Power_On_Hours > 40.000 h → Disken är gammal, ökad risk för fel.
    • PASSED men med varningar → SMART kan missa vissa fel, gör alltid backup.

    7. Löpande övervakning med smartd

    För servrar kan du köra smartd, en bakgrundstjänst som övervakar alla diskar och skickar varningar.

    Aktivera tjänsten:

    sudo systemctl enable smartd
    sudo systemctl start smartd

    Konfiguration:

    /etc/smartd.conf

    Här kan du ange e-postadress för automatiska varningar.

    Slutsats

    SMART är en inbyggd teknik för självdiagnostik i hårddiskar och SSD\:er. Med hjälp av smartmontools i Linux kan administratörer:

    • Kontrollera diskars hälsa.
    • Köra självtester.
    • Upptäcka problem i tid.
    • Få automatiska varningar via smartd.

    Det är en viktig del i förebyggande underhåll. Men kom ihåg:
    👉 SMART ersätter aldrig regelbundna säkerhetskopior.

    Lite exempel

    För ut denna log när jag skriver : smartctl /dev/sdc

    IDSizeValueDescription
    0x000a22Device-to-host register FISes sent due to a COMRESET
    0x000120Command failed due to ICRC error
    0x000320R_ERR response for device-to-host data FIS
    0x000420R_ERR response for host-to-device data FIS
    0x000620R_ERR response for device-to-host non-data FIS
    0x000720R_ERR response for host-to-device non-data FIS

    SATA Phy Event Counters (GP Log 0x11)

    Dessa värden loggas av SATA-fysiklagret (den elektriska/kommunikationsdelen av protokollet).
    De visar olika felhändelser eller specialfall vid kommunikation mellan disk och värddator.

    IDValueBeskrivningFörklaring
    0x000a2Device-to-host register FISes sent due to a COMRESETDisken har skickat Register FIS (Frame Information Structure) till värden p.g.a. en COMRESET (en återställningssignal i SATA-länken). Två gånger har länken återställts.
    0x00010Command failed due to ICRC errorInga kommandon har misslyckats på grund av ICRC (Interface Cyclic Redundancy Check) fel. Ett ICRC-fel innebär korrupt data mellan värd och disk.
    0x00030R_ERR response for device-to-host data FISInga R_ERR (error responses) inträffade vid dataöverföring från enheten till värden.
    0x00040R_ERR response for host-to-device data FISInga felrapporter från värden till enheten när data skickades åt det hållet.
    0x00060R_ERR response for device-to-host non-data FISInga fel vid icke-dataöverföringar från disken (t.ex. kontroll/kommandoramar).
    0x00070R_ERR response for host-to-device non-data FISInga fel vid icke-dataöverföringar från värden till disken.

    Tolkningar

    • Värden på 0 = inga fel, vilket är bra.
    • 0x000a = 2 betyder att SATA-länken har återställts två gånger.
      Det behöver inte vara ett problem, men om värdet ökar ofta kan det tyda på:
    • Dåliga kablar eller kontakter
    • Strömproblem
    • Buggar i kontroller/drivrutiner
    SMART – teknisk faktaruta

    SMART (Self-Monitoring, Analysis and Reporting Technology) är inbyggd i HDD/SSD och övervakar hälsan via interna sensorer och räknare. Enheten lagrar attribut i firmware och rapporterar dem till värddatorn. Tester körs internt i disken och resultat loggas för felsökning.


    Terminologi (SMART-attribut & status)
    • ATTRIBUTE / ID – Namn och numeriskt ID för mätvärdet.
    • VALUE / WORST / THRESH – Normaliserade värden (ofta 100→0 eller 200→0). FAIL inträffar när VALUE ≤ THRESH enligt tillverkarens gräns.
    • RAW_VALUE – Rå räknare (t.ex. antal sektorer, fel, grader °C).
    • TYPEPre-fail (tidig varning) eller Old_age (slitage/ålder).
    • STATUS (smartctl -H)PASSED / FAILED – snabb sammanfattning.
    • TesttyperShort (snabb ytkontroll), Long/Extended (hela ytan), Conveyance (transportskador, främst HDD), Selective (delmängd).
    • LoggarSelf-test log, Error log (senaste I/O-fel med LBA).
    Vanliga indikatorer
    • Reallocated_Sector_Ct > 0 → reservsektorer har tagits i bruk (slitage/problem på medier).
    • Current_Pending_Sector > 0 → osäkra sektorer som väntar på omallokering (hög risk).
    • UDMA_CRC_Error_Count > 0 → ofta kabel/kontaktproblem (SATA).
    • Temperature > ~55 °C → kylproblem, förkortad livslängd.
    • SSD-specifiktWear_Leveling_Count/Media_Wearout (SATA), Percentage Used (NVMe).

    Kompatibilitet
    • HDD (SATA/PATA/SAS) – Ja, stöds brett via smartctl (SAS ofta med HBA-pass-through).
    • SSD (SATA) – Ja, SMART-attribut för slitage, omallokering, temperatur m.m.
    • NVMe-SSD – Ja, via NVMe SMART/Health-logg. smartctl och nvme-cli kan läsa dessa.
    • USB-kabinett/dockorBeror på brygga. Kräver SAT-pass-through; prova smartctl -d sat /dev/sdX. Vissa adaptrar exponerar inte SMART alls.
    • Virtualisering – kräver enhets-/controller-pass-through för tillförlitliga värden.
    Snabbkommandon (Linux)
    # Identifiera enhet
    lsblk    # t.ex. /dev/sda, /dev/sdb, /dev/nvme0n1
    
    # HDD/SSD (SATA)
    sudo smartctl -iH -A /dev/sdX       # info + hälsa + attribut
    sudo smartctl -t short  /dev/sdX    # kort test
    sudo smartctl -t long   /dev/sdX    # långt test
    sudo smartctl -l selftest /dev/sdX  # testlogg
    
    # NVMe-SSD
    sudo smartctl -a /dev/nvme0         # SMART/Health från controllern
    sudo nvme smart-log /dev/nvme0      # alternativ via nvme-cli
      
    Begränsningar och råd
    • SMART är statistiskt/heuristiskt – plötsliga fel kan ske utan förvarning. Ha alltid backup.
    • Tolkning varierar mellan tillverkare; jämför trender över tid snarare än enstaka värden.
    • Kombinera med yttester (t.ex. badblocks) vid osäkerhet.
  • Using RAID and S.M.A.R.T to save yourself from data loss and lot’s of grief

    Jag har valt konfigurera SMART övervakning för att mycket av mina servrar och arbetsstationer, både arbete och hem, nyligen. Särskilt i kombination med RAID, kan SMART hjälpa dig att undvika katastrofer som skulle inträffa när du förlorar dina data i en händelse du hårddiskar bryta.

    Using RAID and S.M.A.R.T to save yourself from data loss and lot’s of grief

Etikett: SMART

  • HWall – ny Linux-app vill ge full koll på datorns hårdvara

    Hur varm är processorn egentligen? Hur snabbt arbetar kärnorna, vad gör grafikkortet och börjar hårddisken visa tecken på problem? Det nya Linux-programmet HWall samlar både hårdvaruinformation och sensordata i ett och samma verktyg – och kan dessutom varna när något börjar bli för varmt eller belastat. Linux har länge haft mängder av verktyg för den…

  • TrueNAS 25.10 “Goldeye” – framtidens öppna lagringssystem

    TrueNAS 25.10 “Goldeye” markerar ett stort steg framåt för öppen lagringsteknik. Den nya versionen introducerar stöd för NVMe over Fabric, öppna GPU-drivrutiner, förbättrad virtualisering och en moderniserad hantering av OpenZFS. Resultatet är en kraftfull och framtidssäker NAS-plattform som kombinerar prestanda i företagsklass med öppen källkod och flexibilitet – redo för allt från hemmalabb till datacenter.…

  • Så kollar du hur hårddisken mår i Linux.

    SMART (Self-Monitoring, Analysis and Reporting Technology) är en inbyggd funktion i hårddiskar och SSD-enheter som kontinuerligt övervakar deras hälsa. Genom att analysera parametrar som temperatur, driftstimmar och antal defekta sektorer kan SMART ge tidiga varningssignaler om en enhet håller på att gå sönder. I Linux kan man med hjälp av paketet smartmontools snabbt kontrollera diskens…

  • Using RAID and S.M.A.R.T to save yourself from data loss and lot’s of grief

    Jag har valt konfigurera SMART övervakning för att mycket av mina servrar och arbetsstationer, både arbete och hem, nyligen. Särskilt i kombination med RAID, kan SMART hjälpa dig att undvika katastrofer som skulle inträffa när du förlorar dina data i en händelse du hårddiskar bryta. Using RAID and S.M.A.R.T to save yourself from data loss…